Errores que convierten una automatización en soporte manual
Por qué una automatización RPA en producción empieza a consumir horas humanas y cómo detectarlo y corregirlo por etapas, sin prometer resultados absolutos.

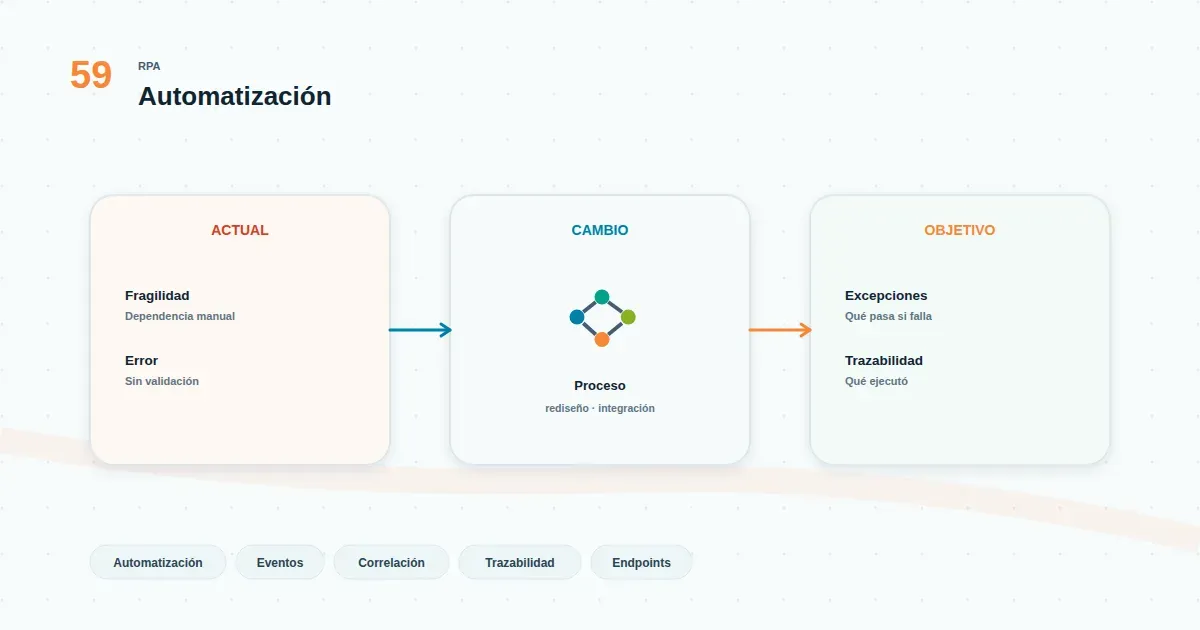
Una automatización no falla solo cuando se cae. Falla cuando empieza a consumir horas humanas que supuestamente había liberado. El síntoma es reconocible: el robot, el flujo o el script sigue "funcionando", pero cada semana alguien del equipo debe revisar por qué un caso no se procesó, corregir un dato de entrada, reintentar una ejecución o explicar por qué una solicitud quedó detenida. La automatización no desapareció; se transformó en una carga operativa silenciosa.
Este artículo no trata sobre qué procesos conviene automatizar. Trata sobre qué ocurre después, cuando una automatización ya está en producción y comienza a degradarse hacia el soporte manual.
Qué hay detrás de una automatización que vuelve a exigir trabajo manual
El problema rara vez es "el robot". Es la combinación de tres factores que se refuerzan entre sí:
- El proceso real cambió y la automatización no. Un formulario agregó un campo, un sistema de origen modificó el formato de un archivo, una validación se volvió obligatoria. La automatización sigue esperando la versión anterior del mundo.
- Las excepciones nunca se modelaron. Se automatizó el camino feliz y se dejó el resto "para revisión manual". Con el tiempo, ese resto crece y deja de ser excepción.
- Nadie es dueño del ciclo de vida. No hay responsable de monitorear, versionar ni actualizar la automatización. Cuando algo se rompe, se resuelve a mano y se sigue adelante.
El resultado operacional es el mismo en distintos contextos: tickets internos que antes no existían, reprocesos, dependencia de una persona que "sabe cómo arreglarlo" y una percepción creciente de que la automatización no cumplió lo que prometía.
Señales tempranas de degradación en producción
Antes de que el problema sea evidente en indicadores, aparecen señales que conviene tratar como alertas:
- Excepciones recurrentes sobre el mismo tipo de caso. No son aleatorias: se concentran en un formulario, un proveedor, una sucursal o un rango horario.
- Reprocesos manuales que se normalizaron. Alguien del equipo "siempre" revisa la bandeja de salida del robot antes de cerrar el día.
- Tickets internos hacia el área que implementó la automatización. Consultas que antes no existían porque el proceso era manual y conocido.
- Dependencia de una persona específica. Solo una persona sabe reiniciar, corregir o desbloquear el flujo. Si no está, el proceso se detiene.
- Ejecuciones "exitosas" que no producen el resultado esperado. El log dice OK, pero el caso no avanzó en el sistema destino.
- Crecimiento del tiempo de intervención humana por caso. Lo que antes se resolvía en minutos ahora requiere investigación.
Ninguna de estas señales, por sí sola, indica que la automatización esté mal diseñada. Indican que no está siendo gestionada como un activo en producción.
Errores frecuentes que reintroducen carga manual
Los patrones que más contribuyen a esta degradación son acotados y reconocibles:
1. Excepciones no modeladas. Se automatizó el flujo principal y se dejó todo lo demás como "caso manual". Sin una ruta explícita para excepciones (reintento, derivación, notificación, registro), cada caso fuera de lo común vuelve al equipo.
2. Cambios no versionados en sistemas de origen. Un campo nuevo, un cambio de formato, una validación adicional o una actualización de la interfaz del sistema legado rompen selectores, mapeos o reglas. Sin control de versiones ni pruebas de regresión, el cambio se descubre cuando ya generó reprocesos.
3. Ausencia de observabilidad. Sin logs estructurados, métricas de ejecución y alertas, la automatización es una caja negra. Se sabe que falló cuando un usuario reclama, no antes.
4. Manejo de errores silencioso. Capturar una excepción y continuar sin registrarla ni notificar es una de las causas más comunes de degradación. El flujo "no falla", simplemente deja de hacer su trabajo.
5. Credenciales y accesos frágiles. Contraseñas que expiran, cuentas de servicio sin rotación gestionada, permisos que cambian tras una revisión de seguridad. Cada uno de estos eventos detiene la automatización hasta que alguien interviene.
6. Dependencia de conocimiento tácito. La lógica del flujo vive en la cabeza de quien lo construyó. No hay documentación operativa, runbook ni criterios de escalamiento.
7. Acoplamiento excesivo a interfaces frágiles. Automatizar sobre pantallas que cambian con frecuencia, sin capas de abstracción ni validaciones intermedias, garantiza mantenimiento reactivo.
8. Falta de dueño operativo. Nadie tiene asignada la responsabilidad de monitorear, actualizar y priorizar mejoras. La automatización queda huérfana.
Cómo validar el impacto técnico y operacional
Antes de corregir, conviene medir. No para justificar la inversión, sino para priorizar qué arreglar primero:
- Trazabilidad por caso. Poder reconstruir qué ocurrió con una transacción específica: entradas, decisiones, salidas, errores. Sin esto, cualquier diagnóstico es especulación.
- Logs estructurados y centralizados. Con identificadores de caso, timestamps, resultado y causa de error. No basta con logs en el equipo donde corre el flujo.
- Métricas de excepción. Tasa de casos derivados a revisión manual, motivos agrupados, evolución en el tiempo.
- Tiempo de intervención humana por caso. Cuánto tarda una persona en detectar, diagnosticar y resolver una excepción. Es el indicador más honesto del costo real.
- Frecuencia de cambios en sistemas de origen. Cuántas veces al mes cambia algo que afecta al flujo. Si es alto, la automatización necesita diseño tolerante al cambio, no solo mantenimiento reactivo.
- Puntos únicos de falla. Personas, credenciales, servidores o dependencias sin redundancia.
Estas mediciones no requieren herramientas sofisticadas. Requieren que alguien las defina y las revise con periodicidad.
Corrección incremental sin prometer resultados absolutos
Reescribir la automatización completa rara vez es la primera opción sensata. El enfoque incremental suele ser más sostenible:
- Priorizar por frecuencia e impacto. Atacar primero las excepciones que más tiempo humano consumen, no las más llamativas técnicamente.
- Instrumentar antes de reescribir. Agregar logs, alertas y trazabilidad al flujo actual permite entender qué está pasando realmente. Muchas veces el problema no es donde se suponía.
- Modelar las excepciones más frecuentes. Convertir en rutas explícitas lo que hoy es "revisión manual": reintento con backoff, derivación con contexto, notificación con datos suficientes para resolver.
- Versionar y probar. Tratar la automatización como software: control de versiones, pruebas de regresión sobre los casos críticos, ambientes separados cuando el impacto lo justifica.
- Definir un dueño operativo. Una persona o equipo responsable de monitorear, priorizar y actualizar. Sin esto, cualquier mejora se diluye.
- Documentar el runbook. Qué hacer cuando falla, a quién escalar, cómo reiniciar, cómo validar que el flujo volvió a operar correctamente.
- Acotar el alcance de cada cambio. Mejoras pequeñas y verificables reducen el riesgo de introducir nuevas fallas mientras se corrige lo existente.
Este enfoque no elimina la posibilidad de que la automatización vuelva a degradarse. La reduce y, sobre todo, la hace detectable antes de que se convierta en una nueva fuente de soporte manual.
Si el problema de fondo es que la automatización nunca tuvo un diseño pensado para operar en producción —con observabilidad, manejo de excepciones y ciclo de vida definido—, conviene revisarlo como parte de una estrategia más amplia de Automatización Inteligente — RPA, no como una corrección aislada. Y si la discusión es sobre qué procesos sí valía la pena automatizar desde el inicio, el análisis de procesos candidatos para RPA aporta criterios que aplican también en la fase de sostenimiento.
Cierre
Una automatización que vuelve a exigir trabajo manual no es un fracaso del proyecto. Es una señal de que el ciclo de vida operativo no está gestionado. Detectar las señales tempranas, medir el impacto real y corregir por etapas es más efectivo —y más barato— que reemplazar la solución completa cada vez que algo se rompe.
Conversemos sobre cómo evaluar Automatización Inteligente — RPA en tu operación.