Exposición de datos sensibles en procesos internos con IA
Dónde se exponen datos sensibles en un flujo interno con IA y qué señales técnicas permiten detectarlo y acotarlo sin frenar la operación.

Cuando una organización incorpora IA en un proceso interno —atención de casos, análisis de contratos, soporte a operaciones, generación de reportes— la conversación suele centrarse en el modelo: cuál se usa, dónde se ejecuta, qué tan bueno es. Sin embargo, la mayor parte de la exposición de datos sensibles no ocurre en el modelo, sino en el proceso que lo rodea. Ahí es donde entran y salen datos personales, donde se consultan fuentes, donde quedan registros y donde se decide quién ve qué.
Este artículo aborda el proceso interno como unidad de análisis: dónde se expone información sensible a lo largo de un flujo operativo con IA y qué señales técnicas permiten detectarlo y acotarlo. Para una mirada general sobre exposición de PII en IA, conviene revisar Datos PII en IA: cómo reducir la exposición sin frenar la operación; aquí el foco es el proceso y su superficie de exposición.
Qué significa exponer datos sensibles (PII) al usar IA en procesos internos
Un proceso interno con IA no es una caja negra. Es una secuencia con al menos cinco puntos donde los datos sensibles pueden quedar expuestos:
- Entrada: el usuario o sistema que inicia el flujo. Puede pegar un correo con RUT, adjuntar una ficha clínica, cargar un contrato con datos de terceros o consultar un caso de cliente.
- Construcción del prompt o consulta: lo que efectivamente se envía al modelo, incluido contexto recuperado de fuentes internas.
- Fuentes consultadas: repositorios, bases de datos, wikis, carpetas compartidas, sistemas de tickets. Si el proceso recupera información, esa recuperación también expone.
- Registros y trazas: logs de prompts, respuestas, errores, métricas de uso. Suelen ser el punto menos gobernado.
- Salida y destinatarios: quién recibe la respuesta, dónde se almacena, si se reenvía, si se copia a otro sistema.
La exposición no depende solo de si el modelo es “privado” o “público”. Un modelo desplegado en infraestructura propia puede seguir exponiendo PII si el proceso envía datos sin clasificar, si las trazas quedan abiertas o si la salida se distribuye sin control. El problema es de proceso, no solo de modelo.
En el contexto chileno, la discusión sobre Ley 21.719 ha puesto el foco en tratamiento, finalidad y trazabilidad de datos personales. No se trata de garantizar cumplimiento —eso exige análisis legal y controles formales—, sino de reconocer que muchos flujos internos con IA hoy no tienen visibilidad suficiente sobre qué datos personales entran, dónde quedan y quién los ve.
Señales técnicas que conviene observar en un proceso interno con IA
Para reducir exposición, primero hay que poder verla. Estas son las señales que un equipo de infraestructura, operaciones o ciberseguridad puede revisar sin instrumentar todo desde cero.
1. Origen y clasificación de los datos de entrada
¿El proceso recibe datos ya clasificados o llegan sin etiqueta? Si un formulario interno no distingue entre “dato operativo” y “dato personal”, cualquier flujo posterior arrastra esa ambigüedad. Señal de alerta: procesos donde el usuario decide libremente qué pegar o adjuntar, sin validación previa.
2. Puntos de entrada y canales
No es lo mismo un proceso batch que consume una tabla controlada, que un chat interno donde cualquier persona escribe lo que quiera. Los canales abiertos amplían la superficie. Conviene inventariar cuántos puntos de entrada tiene el proceso y si todos pasan por el mismo control.
3. Fuentes consultadas y permisos
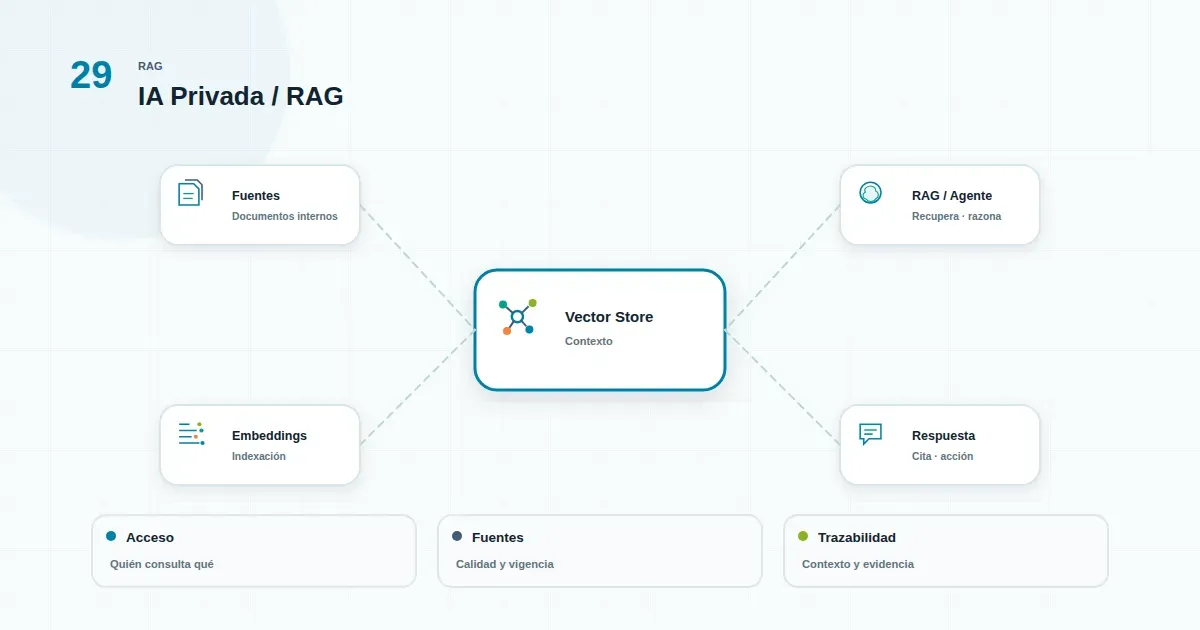
Si el proceso usa recuperación de información (RAG), la pregunta clave es: ¿el usuario que consulta tiene permiso sobre todo lo que el sistema recupera? Un patrón frecuente es que el índice de conocimiento se construya con permisos amplios y luego se consulte desde perfiles más restringidos. Eso genera exposición por diseño.
4. Registros y trazas
¿Se guardan prompts completos? ¿Se guardan respuestas? ¿Por cuánto tiempo? ¿Quién accede a esos logs? Las trazas son útiles para auditoría y para mejorar el proceso, pero si contienen PII sin control se convierten en un repositorio sensible paralelo. Señal de alerta: logs en texto plano, sin retención definida y accesibles a más personas de las necesarias.
5. Salidas y destinatarios
¿La respuesta queda solo en pantalla, se envía por correo, se guarda en un repositorio, se copia a un ticket? Cada destino es una nueva superficie. También importa si la salida mezcla datos de distintas fuentes o si incluye información que el usuario no debería ver.
6. Trazabilidad de extremo a extremo
¿Se puede reconstruir qué datos entraron, qué fuentes se consultaron y qué salió, para un caso específico? Si la respuesta es “no” o “depende de quién lo pida”, la trazabilidad es insuficiente para operar con datos sensibles.
Estas señales no requieren un stack sofisticado. Requieren que alguien del equipo de operaciones o seguridad recorra el flujo completo y documente qué encuentra. En muchos casos, el primer hallazgo es que el proceso real no coincide con el proceso diseñado.
Errores frecuentes y límites al intentar reducir la exposición
Al intentar acotar la exposición, hay patrones que amplifican el problema en lugar de resolverlo.
Confundir “modelo privado” con “proceso controlado”. Desplegar el modelo en infraestructura propia elimina ciertos riesgos de terceros, pero no clasifica datos, no segmenta permisos ni define retención de trazas. La exposición sigue estando en el proceso.
Bloquear todo y frenar la operación. Cuando el control se implementa como prohibición total, los equipos buscan caminos alternativos: pegan datos en herramientas no aprobadas, usan cuentas personales, evitan el flujo oficial. El resultado es menos visibilidad, no menos exposición.
Asumir que el usuario clasificará bien. Pedir a cada persona que decida si un dato es sensible es poco realista en operaciones con volumen. La clasificación debe estar en el proceso, no en la buena voluntad del usuario.
Ignorar las trazas. Muchas iniciativas de control se concentran en la entrada y la salida, y dejan los logs sin gobierno. Ahí suele acumularse la mayor cantidad de PII sin dueño claro.
Suponer que el proveedor resuelve el problema. Los contratos, configuraciones y garantías del proveedor importan, pero no reemplazan el control del proceso interno. La responsabilidad sobre los datos sigue siendo de la organización.
Límites reales que conviene reconocer:
- No existe control que elimine toda exposición; el objetivo es reducirla y hacerla visible.
- La clasificación automática de datos tiene falsos positivos y falsos negativos.
- La trazabilidad completa puede chocar con restricciones de almacenamiento o de privacidad.
- Los controles técnicos no sustituyen definiciones de política ni roles claros.
Criterio práctico para evaluar y reducir la exposición en una operación real
Para un gerente TI, jefatura de infraestructura, operaciones o ciberseguridad, el criterio práctico se puede ordenar en cinco pasos.
1. Inventariar procesos, no herramientas. Liste los procesos internos donde hoy se usa IA o se planea usarla. Para cada uno, identifique entradas, fuentes, trazas y salidas. Priorice los que tratan datos personales o información sujeta a confidencialidad.
2. Clasificar en el punto de entrada. Defina qué tipos de datos puede recibir cada proceso y aplique validación o etiquetado antes de que el dato llegue al modelo. Si un proceso no debería recibir PII, el control debe estar en la entrada, no en la salida.
3. Acotar fuentes y permisos. Verifique que la recuperación de información respete los permisos del usuario que consulta. Si el índice se construyó con permisos amplios, documente el riesgo y defina mitigaciones antes de exponer el proceso a más usuarios.
4. Gobernar trazas y salidas. Defina qué se registra, por cuánto tiempo, quién accede y con qué finalidad. Para las salidas, establezca destinos permitidos y controles de distribución. La trazabilidad debe permitir reconstruir un caso sin convertirse en un nuevo repositorio sin control.
5. Decidir con criterio de operación. El objetivo no es detener el proceso, sino hacerlo operable con exposición conocida y acotada. Eso implica aceptar trade-offs: menos contexto en el prompt, más fricción en la entrada, retención limitada de logs. La decisión debe ser explícita y documentada, no implícita.
Si su organización está evaluando cómo estructurar IA privada con control sobre datos sensibles, en IA Privada · Agentes IA & RAG encontrará el enfoque de arquitectura y gobierno que aplicamos.
La exposición de datos sensibles en procesos internos con IA no se resuelve con una sola medida. Se reduce cuando el proceso es visible, cuando los datos están clasificados en la entrada, cuando las fuentes respetan permisos y cuando las trazas y salidas tienen dueño. Ese es el trabajo operativo que sostiene cualquier iniciativa de IA en producción.
Conversemos sobre cómo evaluar IA Privada · Agentes IA & RAG en tu operación.