Exposición de PII en procesos internos con IA: cómo acotarla
Cómo detectar y acotar la exposición de PII a lo largo de un proceso interno con IA: entradas, prompts, salidas, retención y trazabilidad.

La mayoría de las conversaciones sobre IA y datos sensibles arrancan por la herramienta: qué modelo, qué proveedor, qué región, qué contrato. Ese orden suele llevar a decisiones que se ven bien en una ficha técnica y mal en la operación real. El riesgo rara vez vive en el modelo aislado; vive en el proceso interno que lo alimenta, lo consulta y lo deja registrado.
Este artículo no trata sobre qué IA elegir. Trata sobre cómo mirar un proceso interno concreto —la gestión de un reclamo, la evaluación de un crédito, la atención de un ticket de soporte— y detectar en qué puntos se expone información personal identificable (PII) cuando se incorpora IA en alguna de sus etapas.
Qué implica exponer datos sensibles al usar IA en procesos internos
Un proceso interno es una secuencia: entra un dato, se transforma, se consulta, se decide, se registra y se retiene. La IA puede intervenir en una o varias de esas etapas. La exposición de PII no ocurre en un punto único; se distribuye a lo largo del flujo.
Conviene distinguir tres estados del dato, porque cada uno tiene vectores de exposición distintos:
- En reposo: PII almacenada en bases, repositorios documentales, colas o índices vectoriales. El riesgo es de acceso indebido, retención excesiva o replicación no controlada.
- En tránsito: PII que se mueve entre sistemas, APIs o servicios. El riesgo es de interceptación, pero también de que el dato viaje a destinos no previstos en el diseño original del proceso.
- En uso: PII que aparece dentro de un prompt, un contexto recuperado, una consulta a un agente o una respuesta generada. Es el estado menos gobernado en la mayoría de las operaciones, porque no queda en un repositorio formal ni necesariamente en un log estructurado.
La unidad de análisis correcta no es "la IA" ni "el modelo". Es el proceso interno, con sus entradas, sus reglas, sus salidas y su trazabilidad. Un mismo modelo puede ser aceptable en un proceso de bajo riesgo y problemático en otro, según qué PII circula y qué se hace con ella.
Señales técnicas que conviene observar en un proceso con IA
Antes de evaluar cualquier herramienta, conviene mapear el proceso y observar cuatro señales concretas.
Puntos de entrada de PII al flujo. ¿En qué momento entra el dato personal al proceso? Puede venir de un formulario, un correo, un documento adjunto, una base de clientes o un sistema transaccional. La pregunta operativa es si ese dato entra completo o si puede entrar minimizado. Muchos procesos arrastran campos que la IA no necesita para cumplir su función: RUT, dirección, teléfono, correo, datos de salud, datos financieros. Si el proceso no los requiere, no deberían llegar al componente de IA.
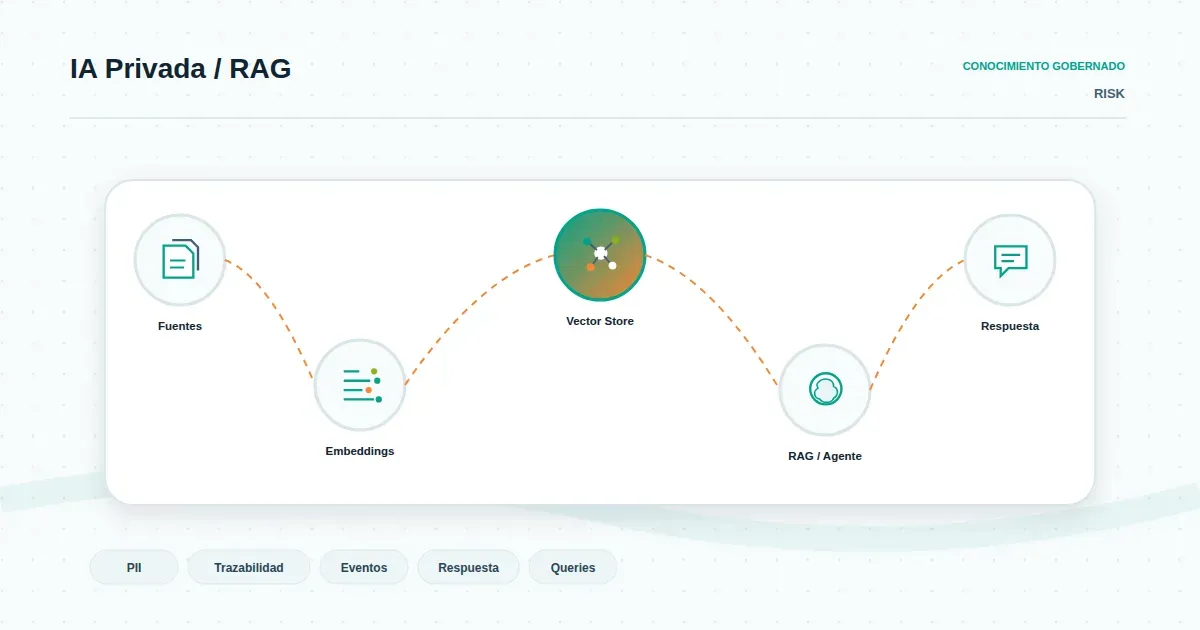
Consultas, prompts y contextos que arrastran PII sin necesidad. Aquí aparece uno de los problemas más frecuentes: el usuario pega un correo completo, un contrato entero o un extracto de base para "que el modelo entienda el contexto". El resultado es que la PII entra al contexto de inferencia sin que nadie haya decidido que era necesario. En arquitecturas RAG, el problema se traslada al índice: si el corpus indexado contiene PII, cada recuperación puede traerla al contexto aunque la consulta no la requiera.
Salidas, registros y retención. Después de que el proceso termina, ¿dónde queda el dato? Hay al menos cuatro lugares a revisar: la respuesta generada, los logs del sistema, las trazas del proveedor (si es un servicio externo) y los artefactos intermedios (embeddings, cachés, colas). La retención por defecto suele ser más larga de lo que el proceso necesita. Un log de depuración que conserva prompts con PII durante meses es un repositorio de datos sensibles que nadie declaró como tal.
Trazabilidad. ¿Se puede reconstruir qué dato entró, qué se consultó, qué se respondió y quién accedió? Si la respuesta es "parcialmente" o "depende del proveedor", hay un problema de gobierno. La trazabilidad no es solo para auditoría; es lo que permite investigar un incidente y acotar su alcance. Sin ella, un evento de exposición se convierte en una incógnita abierta.
Estas señales se observan mejor proceso por proceso. Un inventario de flujos con IA, con su nivel de PII y su criticidad, es más útil que una política general que nadie aplica en el día a día.
Errores frecuentes y límites reales
Tratar la IA como caja negra. Cuando el equipo asume que "lo que pasa dentro del modelo no se puede controlar", deja de gobernar todo lo que sí puede: entradas, contextos, salidas, logs y permisos. La opacidad del modelo no justifica la opacidad del proceso.
Confundir anonimización superficial con reducción efectiva. Enmascarar un RUT en un campo no elimina la exposición si el mismo dato aparece en un texto libre, en un adjunto o en un comentario. La anonimización parcial da falsa tranquilidad y suele fallar justo donde importa.
Asumir que el proveedor cubre el riesgo del proceso interno. Un proveedor puede ofrecer controles sobre su capa, pero no conoce el flujo interno, no decide qué PII entra al prompt y no responde por la retención en los sistemas del cliente. La responsabilidad del proceso es del cliente.
Límites reales. No todo se puede eliminar. Hay procesos donde la PII es inherente a la tarea: evaluar una solicitud, resolver un reclamo, analizar un caso. El objetivo no es cero datos, sino acotar la exposición al mínimo necesario y poder trazarla. Ese es un criterio más honesto y más operable que prometer eliminación total.
Criterio práctico para evaluar la exposición en una operación real
Para evaluar un proceso concreto, conviene responder preguntas de diagnóstico por flujo, no por herramienta:
- ¿Qué PII entra al proceso y en qué punto?
- ¿Cuál de esa PII es estrictamente necesaria para la función que cumple la IA?
- ¿Dónde queda el dato después: respuesta, log, índice, caché, proveedor?
- ¿Cuánto tiempo se retiene y con qué base?
- ¿Quién puede acceder a esos artefactos y con qué permisos?
- ¿Se puede reconstruir una consulta completa si ocurre un incidente?
La priorización debería combinar sensibilidad del dato y criticidad del flujo. Un proceso con datos de salud o financieros y alto volumen merece atención antes que un flujo interno con datos de baja sensibilidad. No todos los procesos requieren el mismo nivel de control.
En el contexto chileno, la preparación frente a marcos como la Ley 21.719 pasa por controles y trazabilidad, no por declaraciones de cumplimiento. Tener inventario de flujos, minimización de datos, retención definida y registros reconstruibles es una base razonable para responder ante una revisión, sin prometer más de lo que se puede sostener.
Si estás evaluando cómo incorporar IA Privada · Agentes IA & RAG en procesos internos con datos sensibles, el punto de partida no es el modelo: es el mapa del proceso y sus puntos de exposición. Un artículo complementario para ese trabajo es Datos PII en IA: cómo reducir la exposición sin frenar la operación, que aborda el equilibrio operativo desde una mirada más general.
Conversemos sobre cómo evaluar IA Privada · Agentes IA & RAG en tu operación.