Qué métricas sirven realmente para gestionar una mesa de ayuda
Criterio práctico para elegir y leer métricas de mesa de ayuda: volumen, tiempo, carga y señales técnicas que permiten decidir sobre la operación real.

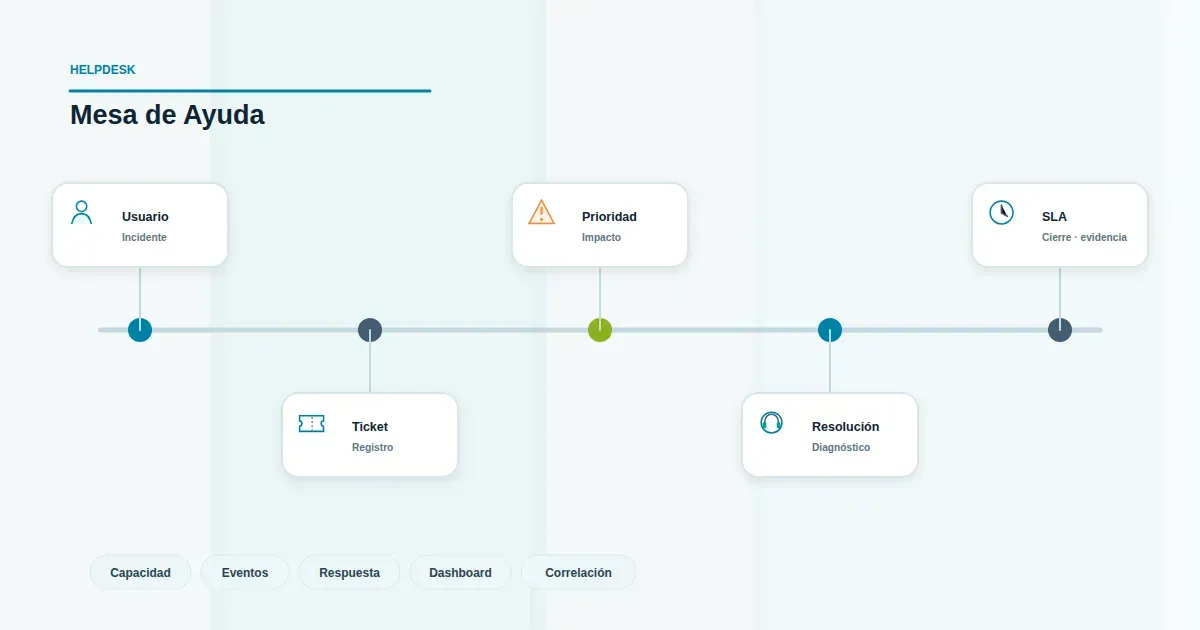
Muchas organizaciones reportan cada mes un tablero con decenas de indicadores. El comité lo revisa, nadie cuestiona los números y la operación sigue igual: usuarios detenidos, tickets que se pierden, tiempos que no se explican. El problema no es la falta de métricas, sino la ausencia de criterio para elegir cuáles mirar y cómo leerlas. Este artículo no trata de definir SLA ni de auditar registros: trata de observabilidad operativa, de qué señales permiten entender el estado real de una mesa de ayuda y decidir sobre ella.
Qué implica medir una mesa de ayuda en una operación real
Medir por obligación y medir para decidir son actividades distintas. La primera produce reportes que se archivan; la segunda produce conversaciones que terminan en cambios concretos: reasignar carga, ajustar turnos, intervenir un servicio que genera reincidencia, corregir un flujo de derivación.
El dolor operacional que justifica la segunda es reconocible: usuarios que no pueden trabajar mientras esperan, tickets sin trazabilidad suficiente para reconstruir qué pasó, tiempos de atención que varían sin explicación y un soporte que solo reacciona cuando el incidente ya escaló. Frente a eso, el volumen de tickets por sí solo no describe la operación. Un mes con 800 tickets puede ser más sano que uno con 500 si los 800 se resolvieron en primera línea y los 500 incluyeron veinte incidentes mayores sin registro adecuado. El conteo agregado oculta la estructura del trabajo.
Medir para decidir exige aceptar una premisa incómoda: no todas las métricas disponibles son útiles, y algunas son engañosas si se leen sin contexto. La selección debe partir de la pregunta que se quiere responder, no de lo que la herramienta entrega por defecto.
Métricas de volumen, tiempo y carga: qué señala cada grupo
Agrupar los indicadores ayuda a evitar el tablero indiscriminado. Tres grupos cubren la mayor parte de las decisiones operativas.
Volumen. Incluye entradas del período, reaperturas y backlog al cierre. Las entradas muestran presión de demanda; las reaperturas delatan resoluciones que no resolvieron; el backlog revela si la capacidad sigue el ritmo de la demanda o si se acumula trabajo invisible. Un backlog estable con entradas crecientes puede indicar que se cierran tickets sin atender la causa. Lo que este grupo no permite concluir es si el servicio mejora: un volumen alto puede reflejar más usuarios, más incidentes o mejor registro, y esas tres cosas se gestionan distinto.
Tiempo. Conviene separar primera respuesta, tiempo de resolución y, sobre todo, tiempo activo versus tiempo en espera. Un ticket puede tardar tres días en cerrarse y haber requerido veinte minutos de trabajo efectivo; el resto fue espera de usuario, de proveedor o de aprobación. Si esa distinción no existe, cualquier conversación sobre desempeño es especulativa. La primera respuesta mide accesibilidad; la resolución mide capacidad de cierre; la descomposición activo/en espera mide dónde está el cuello de botella.
Carga. Distribución por agente, por categoría y por criticidad. Sirve para detectar desbalances, especializaciones no documentadas y categorías que concentran esfuerzo. Comparar carga entre analistas sin normalizar por criticidad produce conclusiones falsas: quien atiende incidentes críticos tendrá menos tickets cerrados que quien resuelve consultas simples, y eso no indica menor productividad.
Cada grupo habilita decisiones distintas. Volumen orienta capacidad y priorización; tiempo orienta procesos y acuerdos internos; carga orienta asignación y formación. Ninguno, por separado, describe la salud del servicio.
Señales técnicas que conviene observar más allá del ticket
El ticket es la unidad de registro, no la unidad de análisis. Hay señales que solo aparecen al cruzar datos o al mirar fuera del sistema.
- Reincidencia sobre el mismo usuario o servicio. Un usuario que abre cinco tickets en un mes por causas distintas no es lo mismo que uno que abre cinco por el mismo síntoma. La segunda situación apunta a una causa raíz no resuelta, probablemente fuera del alcance del primer nivel.
- Tickets que escalan o se reasignan repetidamente. Cada reasignación es tiempo perdido y una señal de que la clasificación inicial o la definición de responsabilidades no funciona. Un ticket que pasa por cuatro manos suele indicar un problema de proceso, no de personas.
- Consultas resueltas fuera del registro formal. Canales paralelos —mensajes directos, pasillos, llamadas no registradas— distorsionan cualquier métrica. Si una parte relevante del trabajo ocurre fuera del sistema, los indicadores describen solo una fracción de la operación.
- Correlación entre eventos de infraestructura y picos de demanda. Un aumento de tickets que coincide con una ventana de mantenimiento, una actualización o una caída de un servicio externo no es un problema de la mesa de ayuda: es un síntoma de otro dominio. Sin esa correlación, el equipo recibe la presión sin la información para explicarla.
Estas señales no reemplazan los indicadores clásicos; los contextualizan. Una mesa de ayuda puede mostrar tiempos aceptables y, al mismo tiempo, sostenerse sobre trabajo no registrado y reasignaciones constantes.
Errores frecuentes al usar métricas de mesa de ayuda
Medir solo lo que es fácil de extraer. Las herramientas reportan con facilidad lo que está estructurado en campos obligatorios. Eso suele dejar fuera la causa raíz, el impacto real en el usuario y el esfuerzo efectivo. Si el tablero se construye por comodidad técnica, se gestiona lo accesible y no lo relevante.
Comparar métricas entre equipos sin contexto de criticidad. Dos equipos con el mismo tiempo promedio de resolución pueden operar en condiciones completamente distintas. La comparación sin normalizar por tipo de caso, criticidad y dependencias externas genera conclusiones injustas y decisiones equivocadas.
Usar promedios que ocultan colas y casos extremos. El tiempo promedio de resolución es cómodo y casi siempre engañoso. Un promedio bajo puede convivir con un porcentaje relevante de tickets que tardan diez veces más. Para gestionar conviene mirar distribución y percentiles, no solo la media.
Convertir la métrica en objetivo. Cuando un indicador se transforma en meta individual, el registro se adapta al indicador: tickets que se cierran antes de resolver, casos que se dividen para mejorar promedios, consultas que se derivan para no afectar el propio número. La métrica deja de describir la operación y empieza a describir cómo el equipo responde a la métrica.
Criterio práctico para elegir y leer métricas
Antes de agregar un indicador al tablero, conviene responder tres preguntas: qué decisión habilita, quién la toma y con qué frecuencia. Si no hay respuesta clara, el indicador probablemente sobra.
Un conjunto acotado y bien leído suele ser más útil que un tablero extenso. Como punto de partida razonable: entradas y backlog, reaperturas, primera respuesta, tiempo activo versus en espera, distribución de carga por criticidad y tasa de reasignación. Sobre esa base se pueden añadir señales específicas según el tipo de operación.
La lectura también requiere disciplina. Las métricas se interpretan en tendencia, no en fotografía aislada; se cruzan entre grupos, no se analizan por separado; y se contrastan con la percepción de los usuarios, que suele detectar antes que el reporte lo que el registro no captura. Cuando un indicador mejora pero los usuarios siguen detenidos, el problema está en el indicador o en lo que se está midiendo.
Sostener esta observabilidad en el tiempo —con trazabilidad, criterios de clasificación y lectura operativa consistente— es parte de lo que distingue a una Mesa de Ayuda que acompaña decisiones de una que solo acumula tickets.
Si en tu operación los reportes existen pero las decisiones no cambian, el punto de partida no es agregar métricas: es definir qué se quiere decidir y qué señal permite hacerlo.
Conversemos sobre cómo evaluar Mesa de Ayuda en tu operación.