Qué métricas mirar antes de culpar a la base de datos por una lentitud
Antes de culpar a la base de datos por una lentitud, conviene saber qué señales observar y cómo interpretarlas con contexto y tendencias.

Cuando los usuarios reportan que "el sistema está lento", la base de datos suele ser el primer sospechoso. Es un reflejo comprensible: es el componente compartido y aparece en casi todos los diagramas de arquitectura. Pero ese reflejo es un sesgo operativo. Acusar a la base de datos sin evidencia lleva a dos errores costosos: intervenir el motor cuando el problema estaba en otra capa, o postergar la acción real mientras se acumulan síntomas.
Este artículo no es un checklist de tuning ni un análisis de bloqueos. Es un marco de lectura para la fase previa: qué observar, cómo interpretar señales con contexto y cuándo escalar.
Qué se necesita observar y por qué antes de culpar a la base de datos
Una transacción típica atraviesa varias capas: la aplicación que la origina, la red que transporta la solicitud, el middleware que la enruta, el motor de base de datos que la ejecuta y el almacenamiento que la persiste. La lentitud percibida es un síntoma agregado; la causa puede estar en cualquiera de esas capas o en su interacción.
El síntoma no distingue causa de correlación. Un aumento en el tiempo de respuesta de una consulta puede coincidir con un pico de CPU en el servidor de base de datos, pero eso no prueba que el pico sea la causa. Puede ser lo contrario: una aplicación que abre más conexiones de las necesarias, un middleware que reintenta llamadas o una red con latencia variable que obliga al motor a mantener sesiones abiertas más tiempo.
La pregunta operativa no es "¿qué está mal en la base de datos?", sino "¿en qué capa se origina el tiempo que el usuario percibe como lentitud?". Responder eso exige señales de varias fuentes, no solo del motor.
Un segundo motivo es el costo de intervenir sin diagnóstico. Cambiar parámetros, agregar índices o reiniciar servicios sin evidencia puede aliviar el síntoma temporalmente y ocultar la causa real, o introducir nuevos problemas. Observar antes de actuar es lo que separa una operación reactiva de una operación con criterio.
Métricas, logs y señales que realmente aportan diagnóstico
No todas las métricas disponibles aportan al diagnóstico. Muchas sirven para capacidad o tendencias de largo plazo, pero no para entender una lentitud puntual. Otras son ruido si se leen sin contexto.
Señales del motor de base de datos
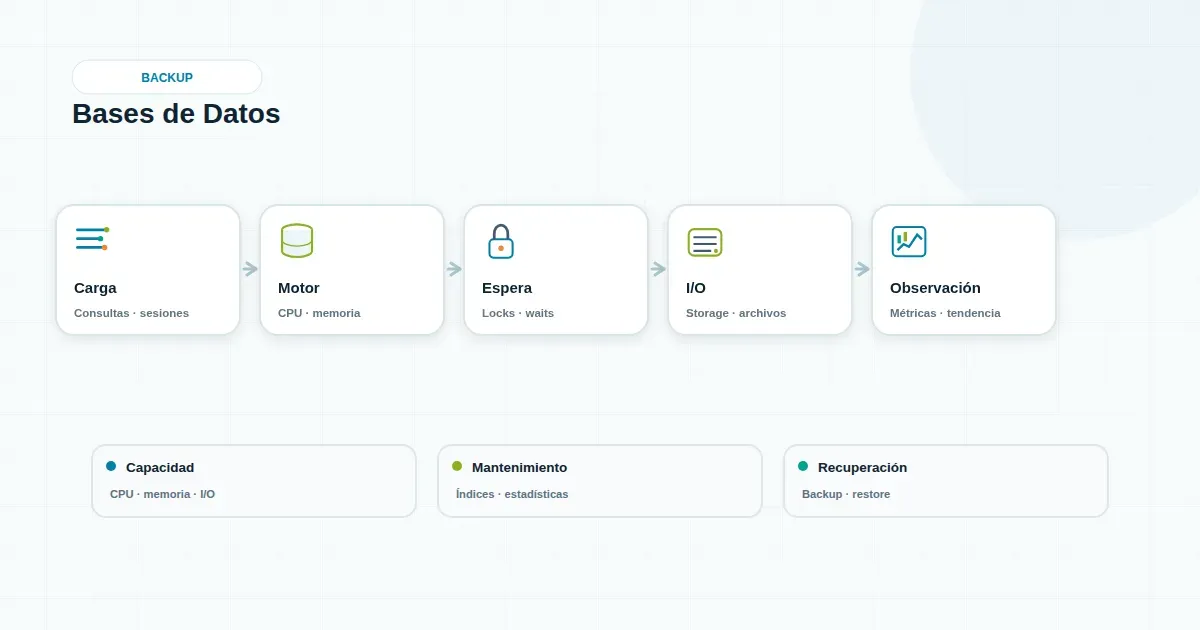
- Tiempos de espera (wait times): indican en qué está esperando el motor. Esperas por I/O, locks, latches, red o CPU apuntan a causas distintas. Un aumento de esperas por I/O sugiere presión de almacenamiento; esperas por locks sugieren contención entre sesiones.
- Uso de CPU: útil, pero engañoso aislado. Un CPU alto puede ser causa o consecuencia. Conviene ver si coincide con un aumento de consultas, de concurrencia o de trabajo por consulta.
- I/O y latencia de almacenamiento: tiempos de lectura y escritura, colas y throughput. Si el almacenamiento responde lento, el motor espera, y eso se refleja en los tiempos de espera.
- Memoria y presión de buffer: páginas en memoria, lecturas físicas versus lógicas y presión de buffer. Una caída en la tasa de aciertos puede explicar un aumento de I/O.
- Concurrencia y sesiones activas: número de sesiones, conexiones abiertas, transacciones activas y su duración. Un crecimiento sostenido de sesiones sin aumento de trabajo útil suele indicar fugas de conexión o mal manejo de pools.
- Planes de ejecución: para consultas específicas, el plan revela si el motor hace un trabajo distinto al esperado. Un cambio de plan puede explicar una lentitud puntual sin que el motor esté "mal".
Señales de la aplicación y el middleware
- Latencia de llamadas: tiempo que la aplicación mide desde que envía una consulta hasta que recibe la respuesta. Si la aplicación reporta latencias altas pero el motor reporta tiempos de ejecución bajos, la diferencia está en la red, el middleware o la propia aplicación.
- Timeouts y reintentos: un aumento de timeouts puede indicar que la aplicación espera más de lo que el motor tarda en responder. Los reintentos generan carga adicional que puede confundirse con un problema del motor.
- Pool de conexiones: tamaño del pool, conexiones en uso y conexiones esperando. Un pool mal dimensionado produce esperas en la aplicación que se manifiestan como lentitud, aunque el motor esté ocioso.
- Errores y excepciones: no toda lentitud es tiempo; a veces es una secuencia de errores que la aplicación maneja con reintentos y el usuario percibe como demora.
Señales de red e infraestructura
- Latencia de red entre capas: cada round-trip entre aplicación y motor suma tiempo. En arquitecturas con muchas llamadas pequeñas, esto se acumula.
- Ancho de banda y saturación: transferencias grandes o tráfico concurrente afectan los tiempos percibidos.
- Estado de los hosts: CPU, memoria y I/O del servidor de aplicación, del middleware y del servidor de base de datos. Un host saturado en cualquier capa puede ser el origen.
Logs y trazas
Los logs del motor, de la aplicación y del middleware son la fuente más subestimada. Un log de consultas lentas con su plan, duración y frecuencia permite correlacionar con otras señales. Las trazas distribuidas, cuando existen, permiten seguir una transacción a través de las capas y ver dónde se concentra el tiempo. Sin trazas, la correlación por marcas de tiempo es la herramienta más accesible.
La clave no es recolectar todo, sino poder cruzar señales. Una métrica aislada rara vez explica una lentitud; dos o tres señales correlacionadas en el tiempo suelen bastar para orientar el diagnóstico.
Cómo interpretar tendencias y evitar alertas sin contexto
El error más común en observabilidad no es la falta de métricas, sino la falta de contexto. Un umbral fijo de CPU al 80% puede disparar alertas en horarios de carga normal y no dispararse durante una degradación real. Una alerta de "consultas lentas" sin comparación contra una línea base no distingue entre una consulta que siempre fue lenta y una que se degradó.
Para interpretar tendencias conviene:
- Establecer una línea base por franja horaria y día de la semana. Lo que es normal un lunes a las 9:00 no lo es un domingo a las 3:00. Sin línea base, cualquier umbral es arbitrario.
- Mirar tasas, no solo valores absolutos. Un aumento de conexiones es más informativo que el número total. Una tasa de crecimiento sostenida anticipa problemas antes de que se manifiesten.
- Correlacionar en el tiempo. Si el pico de CPU coincide con un aumento de latencia de red, la causa probable no es el motor. Si coincide con un aumento de consultas de una aplicación específica, el foco está ahí.
- Distinguir entre degradación gradual y evento puntual. La degradación gradual suele indicar crecimiento, acumulación o cambio de patrón de uso. El evento puntual suele indicar un cambio reciente: despliegue, cambio de plan, pico de tráfico o fallo de un componente.
- Evitar alertas sin acción asociada. Una alerta que no lleva a una decisión concreta es ruido. Si no se sabe qué hacer cuando se dispara, probablemente no debería configurarse como alerta.
Antes de escalar un incidente como "problema de base de datos", conviene poder responder tres preguntas: ¿qué capa concentra el tiempo?, ¿desde cuándo?, ¿qué cambió en ese periodo? Si no hay respuesta, el diagnóstico está incompleto.
Criterios de escalamiento y operación
La decisión de escalar no debería depender de la intuición ni de la presión del momento. Conviene definir criterios antes de que ocurra el incidente, de modo que la respuesta sea consistente y no dependa de quién esté de turno.
Cuándo escalar al equipo de base de datos
- Cuando las señales del motor muestran esperas anómalas sostenidas que no se explican por cambios en la aplicación o la red.
- Cuando hay evidencia de contención interna: locks, latches, presión de memoria o I/O que correlaciona con la degradación.
- Cuando un cambio de plan de ejecución coincide con la aparición del problema.
- Cuando el volumen o el patrón de consultas cambió de forma que el motor ya no puede absorber con la configuración actual.
Cuándo mirar primero otras capas
- Cuando la aplicación reporta latencias altas pero el motor reporta tiempos de ejecución normales.
- Cuando hay timeouts o reintentos en la aplicación sin correlato en el motor.
- Cuando el pool de conexiones muestra esperas o saturación.
- Cuando la latencia de red o el estado de los hosts muestra anomalías.
Qué documentar en cada escalamiento
Conviene registrar: marca de tiempo del inicio, síntoma reportado, señales observadas con su fuente, cambios recientes en cualquier capa y acciones tomadas. Esta documentación ayuda al diagnóstico inmediato y construye la línea base para futuros incidentes.
Operación continua
Más allá del incidente puntual, la observabilidad diagnóstica requiere acuerdos operativos: qué señales se monitorean de forma permanente, con qué frecuencia se revisan las tendencias, quién interpreta cada fuente y cómo se comunican los hallazgos entre equipos. Sin estos acuerdos, cada lentitud se convierte en una discusión sobre percepciones en lugar de una conversación sobre evidencia.
La Administración de Bases de Datos DBA incluye, entre otras cosas, la definición de qué observar y cómo interpretarlo. No se trata solo de tener herramientas de monitoreo, sino de acordar qué señales importan, cómo se correlacionan y cuándo se escala. Sin ese acuerdo, la observabilidad se convierte en una colección de dashboards que nadie usa durante un incidente.
En operaciones con equipos distribuidos, la claridad sobre estos criterios reduce el tiempo de diagnóstico y evita intervenciones innecesarias sobre el motor. También ayuda a distinguir entre un problema recurrente que requiere cambio estructural y un evento puntual que se resuelve con una acción acotada.
Si en tu organización la lentitud suele terminar en una intervención sobre la base de datos sin evidencia previa, vale la pena revisar qué señales se observan y cómo se interpretan.
Conversemos sobre cómo evaluar Administración de Bases de Datos DBA en tu operación.