Qué métricas mirar antes de culpar a la base de datos por una lentitud
Guía de observabilidad para diagnosticar lentitud: qué señales mirar por capa, cómo interpretar tendencias y cuándo escalar a un especialista DBA.

Cuando una aplicación se pone lenta, la base de datos suele ser la primera sospechosa. Es un reflejo comprensible: es la capa donde convergen usuarios, transacciones y datos. Pero ese reflejo tiene un costo operacional. Si el equipo reinicia servicios, agrega índices o cambia parámetros del motor antes de observar el comportamiento completo del sistema, puede introducir cambios que no resuelven la lentitud y alterar una línea base que después será difícil reconstruir.
Este artículo no es un checklist de tuning ni un catálogo de acciones correctivas. Se detiene un paso antes: qué señales conviene observar y cómo interpretarlas antes de atribuir una lentitud a la base de datos.
Qué observar antes de culpar a la base de datos
El error más frecuente no es mirar la métrica equivocada, sino mirarla en el orden equivocado. Cuando la lentitud se detecta en la aplicación, la reacción habitual es abrir la consola del motor y buscar consultas costosas. Ese enfoque asume que la causa está en la base de datos y convierte la observación en una confirmación de la hipótesis inicial.
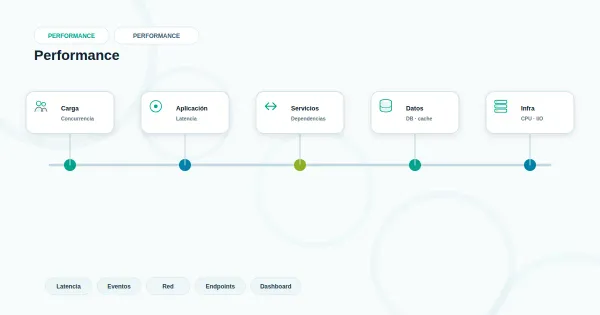
Un diagnóstico razonable parte de otra pregunta: ¿en qué capa se origina el tiempo que el usuario percibe como lentitud? La respuesta exige observar al menos cuatro capas —aplicación, red, sistema operativo y motor de base de datos— y correlacionarlas en la misma ventana temporal. Sin esa correlación, cualquier métrica aislada puede sostener casi cualquier conclusión.
Lo que se pierde cuando se salta la observación es la línea base. Un motor que hoy responde en 40 ms puede haber respondido en 25 ms la semana pasada, y esa diferencia es más informativa que el valor absoluto. Si el equipo interviene antes de registrar el estado previo, pierde la referencia contra la cual medir el efecto real de cualquier cambio.
Métricas, logs y señales que aportan diagnóstico real
No todas las señales tienen el mismo valor diagnóstico. Algunas describen síntomas, otras describen causas, y varias se confunden con problemas de base de datos cuando se originan en otra capa.
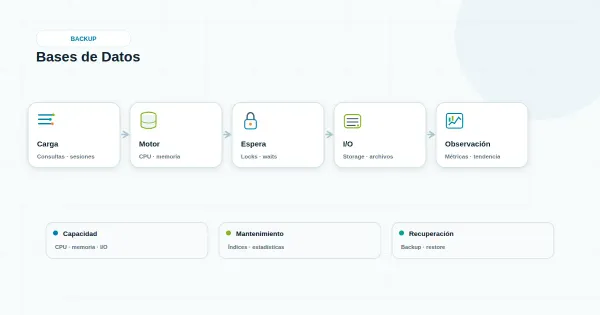
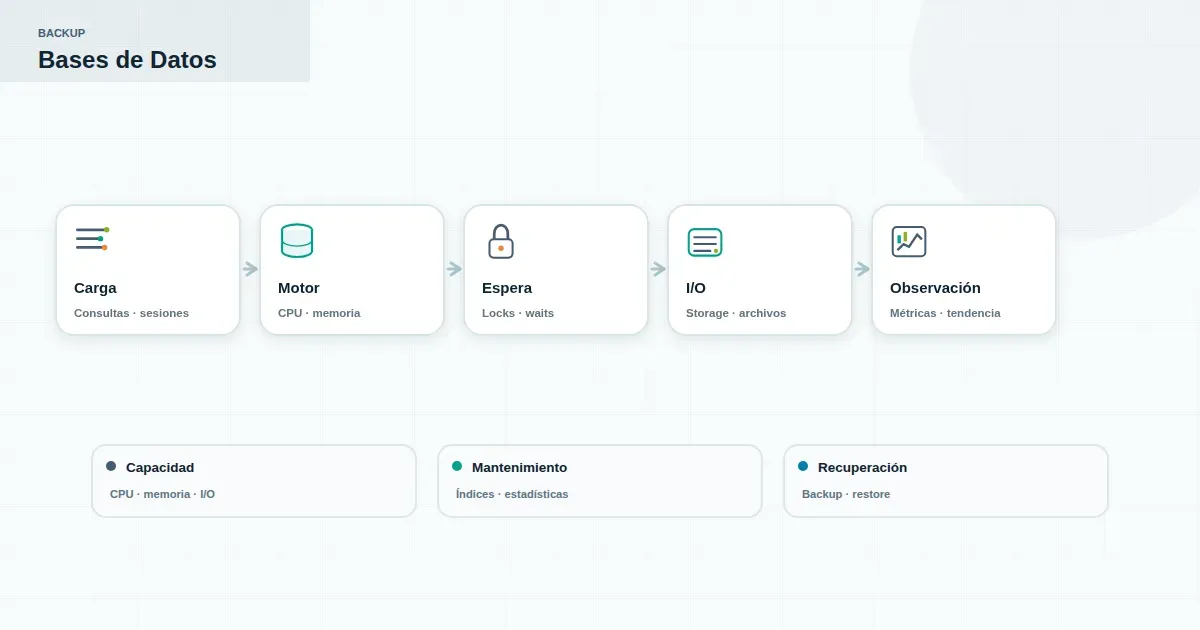
En el motor de base de datos, las señales que aportan contexto son: tiempo de espera acumulado por categoría (no solo el total), sesiones activas versus sesiones en espera, latencia de lectura y escritura, y tasa de compilaciones o recompilaciones de planes. Un aumento de esperas no indica por sí mismo un problema del motor: puede reflejar contención de CPU, I/O saturado o bloqueos originados en la aplicación.
En el sistema operativo, conviene observar utilización de CPU por proceso, presión de memoria, latencia de disco y colas de I/O. Un motor con tiempos de respuesta altos y un disco con latencia elevada apunta a almacenamiento, no a consultas mal escritas. Ignorar esta capa es una de las causas más comunes de diagnósticos equivocados.
En la red, la latencia entre la aplicación y el motor, la tasa de retransmisiones y el tamaño de los paquetes explican lentitudes que no aparecen en ninguna métrica interna del motor. Una aplicación que abre muchas conexiones cortas puede degradar su desempeño por razones de red antes que por razones de base de datos.
En la aplicación, el tiempo de respuesta por endpoint, el número de llamadas por transacción de usuario y la política de pooling de conexiones suelen explicar más que cualquier consulta individual. Un endpoint que ejecuta veinte consultas donde antes ejecutaba tres genera lentitud sin que ninguna consulta sea lenta por sí sola.
Señales que suelen confundirse con problemas de base de datos: picos de CPU del motor causados por recompilaciones debidas a cambios de plan, esperas atribuidas al motor que en realidad provienen de bloqueos originados en la aplicación, y aumentos de latencia que coinciden con ventanas de backup o procesos batch. Distinguirlas exige observar la secuencia temporal, no el valor puntual.
Cómo interpretar tendencias y evitar alertas sin contexto
Un umbral aislado no es un diagnóstico. Que una métrica supere un valor definido indica que algo cambió, no qué cambió ni si importa. La interpretación útil surge de tres prácticas: comparar contra una línea base, observar la variación en el tiempo y correlacionar entre capas.
La línea base se construye observando el sistema en condiciones normales, no durante un incidente. Sin ella, cualquier valor parece anómalo o, peor, cualquier valor parece normal. Una base de datos con 200 sesiones activas puede ser sana en un sistema con miles de usuarios concurrentes y problemática en uno con decenas.
La variación importa más que el valor absoluto. Un aumento sostenido de la latencia de escritura durante tres días consecutivos es una señal distinta de un pico de diez minutos. El primero sugiere un cambio estructural —crecimiento de datos, degradación de índices, presión de almacenamiento—; el segundo puede corresponder a un proceso puntual.
La correlación entre capas es lo que permite descartar hipótesis. Si el tiempo de respuesta de la aplicación sube, la latencia del motor se mantiene estable y la latencia de red aumenta, el origen probable está en la red. Si el motor muestra esperas altas y el sistema operativo muestra I/O saturado, el origen probable está en el almacenamiento. Si el motor muestra consultas con planes degradados y el sistema operativo está estable, entonces sí conviene profundizar en el motor.
Un error frecuente es configurar alertas sobre métricas sin contexto: CPU del motor por encima de un porcentaje, número de conexiones por encima de un umbral, duración de consultas por encima de un límite. Estas alertas generan ruido y, con el tiempo, se ignoran. Alertas más útiles combinan condiciones: latencia de escritura sostenida por encima de la línea base durante más de X minutos, o crecimiento de esperas específicas correlacionado con aumento de latencia percibida por la aplicación.
Criterios de escalamiento y operación
No todo hallazgo justifica escalar a un especialista DBA. La decisión depende de si el problema es recurrente, si afecta a usuarios o procesos críticos, y si el equipo interno tiene visibilidad suficiente para actuar sin riesgo.
Escalar tiene sentido cuando la lentitud se repite en ventanas similares sin causa aparente; cuando las señales apuntan a contención interna del motor (esperas, planes, estadísticas) que requiere criterio especializado; cuando hay riesgo de indisponibilidad o de degradación progresiva; o cuando el equipo no puede descartar la base de datos como origen y necesita una revisión estructurada.
Documentar la evidencia antes de escalar ahorra tiempo y evita diagnósticos repetidos. Un registro útil incluye: ventana temporal exacta del incidente, métricas observadas por capa, consultas o procesos relevantes en ese intervalo, cambios recientes en aplicación o infraestructura, y el efecto percibido por los usuarios. Esta documentación también sirve para comparar contra incidentes previos y detectar patrones.
En operación continua, conviene revisar periódicamente las líneas base, ajustar umbrales según el crecimiento del sistema y mantener un inventario de las consultas y procesos más sensibles. La Administración de Bases de Datos DBA cubre este tipo de observación sostenida cuando el equipo interno no tiene capacidad dedicada, pero el criterio de qué observar y cómo interpretarlo sigue siendo responsabilidad compartida entre operaciones, aplicación y datos.
Cierre
Culpar a la base de datos por una lentitud es una hipótesis, no un diagnóstico. Antes de actuar sobre el motor conviene observar la aplicación, la red, el sistema operativo y el propio motor en la misma ventana temporal, comparar contra una línea base y correlacionar señales entre capas. Ese orden reduce intervenciones innecesarias, preserva la referencia para medir cambios y permite escalar con evidencia cuando corresponde.
Conversemos sobre cómo evaluar Administración de Bases de Datos DBA en tu operación.