Middleware: dónde se pierde el control del flujo entre aplicaciones y datos
El middleware concentra los síntomas que luego aparecen como aplicaciones inestables. Claves para leer el recorrido de una transacción y atribuir la causa.
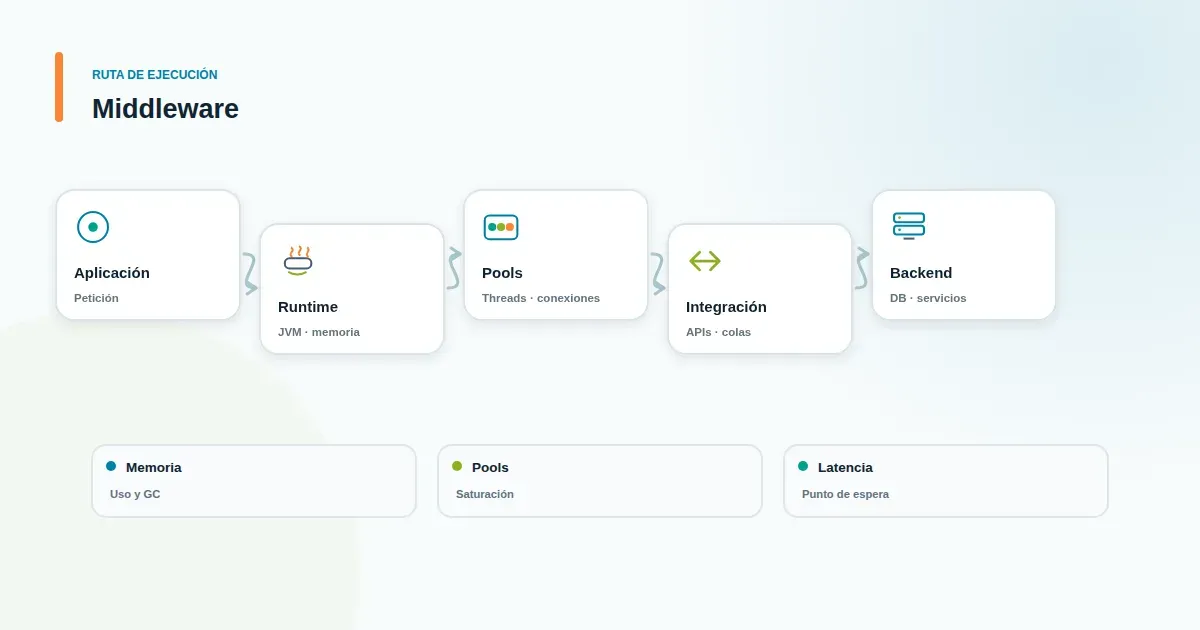
Cuando una aplicación responde lento, el primer reflejo es revisar la aplicación. Después la base de datos. Rara vez la capa del medio. En arquitecturas con integración intensiva, el middleware concentra los síntomas que luego aparecen aguas arriba como "la aplicación está inestable". Entender el recorrido real de una transacción —y las señales que esa capa deja cuando se degrada— permite atribuir el problema antes de reiniciar componentes a ciegas.
El recorrido real de una transacción: de la aplicación a la base de datos y de vuelta
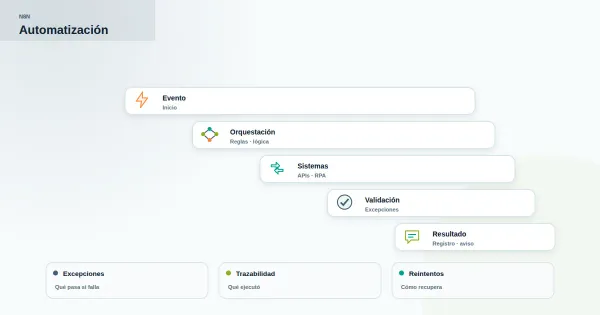
Una transacción típica no viaja en línea recta. La aplicación origen invoca un servicio; ese servicio pasa por la capa intermedia, que resuelve ruteo, transformación, autenticación, políticas de reintento y gestión de conexiones; desde ahí se llama a una API o directamente a la base de datos; la respuesta recorre el mismo camino en sentido inverso, con transformaciones adicionales antes de llegar al consumidor original.
Cada salto agrega tiempo. La latencia total no es la suma de las latencias individuales medidas en aislamiento: es esa suma más la contención. Con holgura, la contención es marginal. Cuando la capa se satura, el tiempo que una petición espera un hilo, una conexión o un turno en la cola puede superar varias veces el tiempo útil de trabajo. Ahí el recorrido deja de ser predecible.
La degradación no se manifiesta donde se origina. Un pool de conexiones agotado en la capa intermedia aparece como timeout en la aplicación origen. Una JVM con presión de memoria por acumulación de objetos en transformaciones aparece como pausas intermitentes que el usuario percibe como "la aplicación se cuelga". Un error de integración por un contrato de API que cambió sin versionar aparece como excepción en el servicio consumidor, no en el proveedor.
Ese desfase entre origen y síntoma encarece la atribución. Operaciones ve la alerta en el monitoreo de la aplicación, escala a desarrollo, este revisa su código y no encuentra nada, y el problema se cierra sin causa raíz hasta que vuelve a ocurrir. Mientras tanto, la capa intermedia acumula evidencia que nadie lee: colas de espera, tasas de error por endpoint, tiempos de respuesta por backend, uso de heap, conexiones activas versus disponibles.
Qué aporta la capa intermedia al flujo y qué no debería cargar
La capa intermedia existe para desacoplar. Permite que la aplicación origen no conozca los detalles del backend —protocolo, formato, disponibilidad— y que el backend no dependa de cuántos consumidores lo invocan ni de cómo lo hacen. Esa mediación habilita versionado de APIs sin romper consumidores, aplica políticas de seguridad de forma centralizada, absorbe picos mediante colas y permite sustituir un backend sin tocar la aplicación.
El límite de esa función importa igual. La capa intermedia no debería alojar lógica de negocio compleja, ni estado que debería residir en la base de datos, ni reglas que pertenecen a los dominios que conecta. Cuando eso ocurre, deja de ser un mediador y pasa a ser un componente crítico con lógica propia, más difícil de versionar, escalar y diagnosticar. Cuanta más carga semántica acumula, más superficie tiene para degradarse y más difícil es aislar la causa cuando falla.
En términos de flujo, aporta tres cosas concretas: ruteo (dirigir cada petición al backend correcto según reglas), transformación (adaptar formatos y contratos entre extremos que no hablan el mismo idioma) y control (aplicar límites, cuotas, reintentos y políticas de timeout). Lo que no debería cargar es la responsabilidad de la consistencia de los datos ni la de la disponibilidad del negocio: si la capa cae, el flujo se interrumpe; si además concentra estado o lógica crítica, la recuperación deja de ser un reinicio y pasa a ser una reconstrucción.
Señales que conviene observar cuando la capa se vuelve el punto de fricción
La dificultad práctica es que la mayoría de estos indicadores existen, pero no se leen en conjunto. Observar solo uno lleva a conclusiones parciales: un heap alto puede ser normal en un ciclo de recolección; un pool con conexiones activas al máximo puede ser un pico legítimo. La lectura útil aparece cuando varias señales coinciden en el tiempo y apuntan al mismo segmento del recorrido.
Vale la pena instrumentar y correlacionar, como mínimo:
- Latencia por salto, no solo de extremo a extremo. Si el tiempo total sube pero el tiempo de trabajo del backend se mantiene, la espera está en la capa intermedia.
- Tiempo de espera en cola dentro de la capa: cuánto aguarda una petición antes de ser procesada. Es la señal más directa de saturación y la que menos se monitorea.
- Uso de heap y frecuencia de recolección en la JVM, con atención a pausas que coinciden con picos de latencia percibida.
- Conexiones activas versus disponibles en los pools, y tasa de espera por conexión. Como señal de contexto, el agotamiento de pools indica contención en el flujo.
- Tasa de error por endpoint y por backend, separando errores de la capa (timeout, rechazo, transformación fallida) de errores propagados desde el backend.
- Reintentos: un incremento suele amplificar la carga sobre un backend ya degradado y convertir una falla parcial en una caída en cascada.
La correlación temporal entre estas señales responde la pregunta que importa: ¿el flujo se degrada porque la capa intermedia está saturada, o la capa se satura porque un backend aguas abajo dejó de responder a tiempo? Son causas distintas con remedios distintos; confundirlas lleva a escalar recursos donde no corresponde o a reiniciar componentes que no eran el problema.
Criterios para evaluar esta arquitectura en la práctica
Antes de intervenir, conviene responder algunas preguntas de diseño que determinan si la capa intermedia está bien posicionada para sostener el flujo:
- ¿El recorrido de una transacción está documentado de punta a punta, con saltos, timeouts y reintentos en cada tramo? Sin ese mapa, la atribución se hace por intuición.
- ¿Los timeouts están alineados entre capas? Un timeout más largo en la capa intermedia que en el consumidor genera trabajo inútil y conexiones retenidas.
- ¿Los reintentos tienen límite y backoff, o pueden amplificar la carga sobre un backend degradado?
- ¿La observabilidad permite ver la latencia por salto y el tiempo en cola, o solo el total?
- ¿La capa intermedia tiene lógica de negocio que debería estar en otro lugar, aumentando su criticidad sin necesidad?
Estas preguntas no se responden con una herramienta, sino con criterio arquitectónico y evidencia operacional. Cuando la capa intermedia se vuelve el punto de fricción, el trabajo no es reemplazarla sino entender dónde se perdió el control del flujo y qué señales lo estaban anunciando. Ese es el terreno donde una evaluación estructurada de Middleware aporta más que la sustitución de componentes.
Conversemos sobre cómo evaluar Middleware en tu operación.