Tuning en Wazuh: cuándo una alerta útil se convierte en ruido
Diagnóstico del ciclo de vida de una alerta en Wazuh: señales de degradación, errores frecuentes y criterio para decidir entre ajustar, silenciar o retirar una regla.

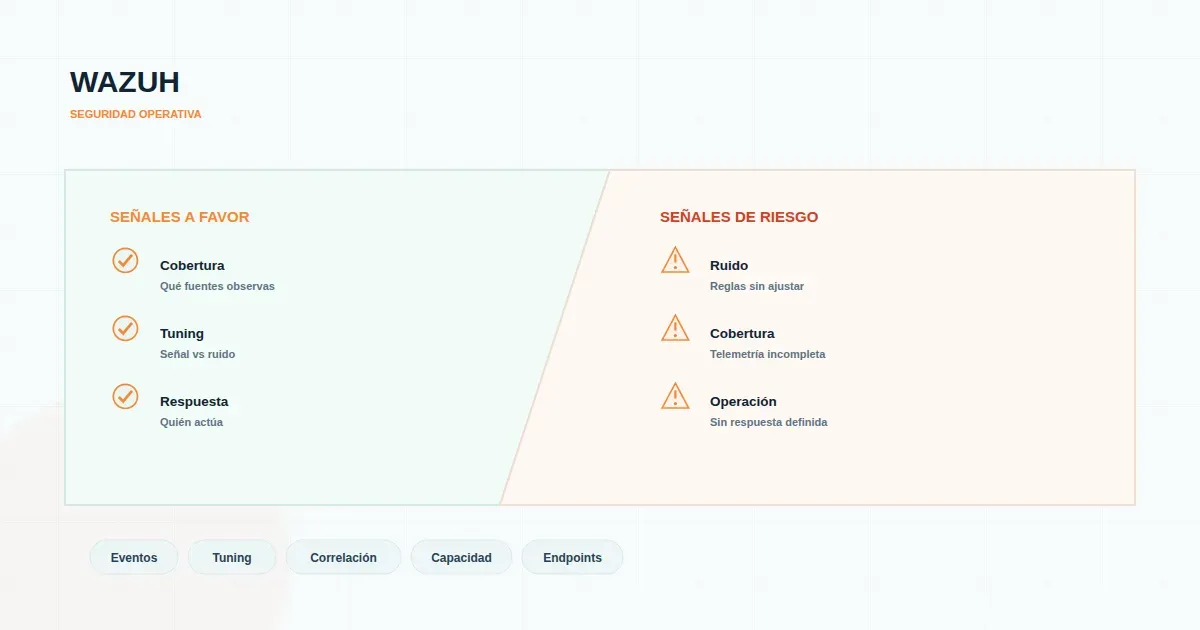
Una regla que al inicio de la operación señalaba algo relevante puede, meses después, generar cientos de eventos diarios que nadie revisa. El problema no suele ser la regla en sí, sino la ausencia de un ciclo de revisión que detecte cuándo dejó de aportar señal y empezó a aportar volumen. Este artículo aborda ese punto de quiebre: cómo diagnosticarlo, qué señales técnicas observar y con qué criterio decidir entre ajustar, silenciar o retirar.
Qué significa hacer tuning de reglas y alertas en Wazuh
Wazuh procesa eventos provenientes de agentes, decoders y reglas. Cada regla define condiciones sobre el evento (origen, usuario, comando, ruta, frecuencia) y asigna un nivel de severidad. El tuning, en este contexto, no es "bajar el ruido" de forma genérica: es el trabajo continuo de mantener la correspondencia entre lo que la regla detecta y lo que la operación considera relevante.
En un entorno empresarial, esa correspondencia se rompe por razones previsibles:
- Cambios en la infraestructura: un servidor nuevo, un servicio que se migra, un rango de IP que se reasigna. La regla sigue disparando, pero el contexto que la hacía útil ya no existe.
- Crecimiento del parque: lo que en 20 agentes generaba 5 alertas diarias, en 200 agentes genera 50. El volumen escala con la base instalada, no con la criticidad.
- Automatizaciones legítimas: scripts de despliegue, tareas de respaldo, rotaciones de credenciales. Actividades esperadas que coinciden con patrones que la regla marca como sospechosos.
- Deriva de la línea base: el comportamiento "normal" de la operación cambia y la regla no se actualiza.
El tuning es una función operativa con dueño, frecuencia y criterio, no una configuración que se hace una vez. Sin ese ciclo, la degradación es silenciosa: nadie decide convertir una alerta en ruido, simplemente deja de mirarse.
Cómo se degrada una alerta útil: señales técnicas a observar
El paso de señal a ruido rara vez es abrupto. Se puede detectar con indicadores observables en el propio Wazuh y en la operación que lo consume.
Volumen sin cambio de criticidad. Si una regla de nivel medio o alto empieza a disparar con una frecuencia que crece semana a semana, y ese crecimiento no corresponde a un cambio real en la infraestructura, hay degradación. El volumen por sí solo no es el problema: el problema es el volumen que ya no se traduce en investigaciones.
Duplicidad y solapamiento entre reglas. Varias reglas pueden disparar sobre el mismo evento con distinto nivel. El analista ve tres alertas donde hay un solo hecho. Esto suele aparecer cuando se agregan reglas personalizadas sin revisar las existentes, o cuando se importan rulesets de terceros sin depurarlos.
Pérdida de correlación. Una alerta aislada puede ser informativa; la misma alerta repetida en el mismo host en una ventana corta puede ser un incidente. Si la operación no tiene reglas de correlación (o las tiene pero disparan sobre eventos que ya no ocurren), cada evento se trata como unidad y el patrón se pierde.
Falta de contexto en el evento. Una alerta que dice "comando ejecutado" sin indicar usuario, host, proceso padre o ruta es difícil de triar. Cuando el analista necesita abrir el evento crudo para decidir si importa, la alerta ya está aportando más costo que señal.
Tiempo de triage creciente. Indicador operativo, no técnico, pero decisivo: si el tiempo medio entre recepción y decisión sobre una alerta crece, o si la proporción de alertas cerradas como "falso positivo" o "esperado" aumenta, la regla está en zona de ruido.
Alertas que se cierran sin lectura. El síntoma más claro. Cuando el equipo reconoce el patrón por el asunto y cierra sin abrir, la regla dejó de cumplir su función, aunque siga técnicamente activa.
Ninguna de estas señales exige instrumentación sofisticada. La mayoría se obtiene revisando periódicamente el top de reglas por volumen, la tasa de cierre y la distribución de severidades en el dashboard.
Errores frecuentes y límites del tuning
El tuning mal ejecutado genera problemas nuevos. Los más comunes:
Silenciar sin criterio. Desactivar una regla porque "molesta" elimina la señal y también la evidencia de que algo está ocurriendo. Si la regla se silencia, conviene dejar registro de la decisión, la justificación y la fecha de revisión. Un silencio sin trazabilidad es indistinguible de un olvido.
Ajustar sin línea base. Cambiar umbrales o frecuencias sin haber medido el comportamiento previo convierte el tuning en ensayo y error. La línea base no necesita ser sofisticada: basta con saber cuántos eventos genera la regla en un periodo representativo, en qué hosts y con qué distribución horaria.
Confundir severidad con prioridad. Subir el nivel de una regla no la hace más atendible; muchas veces solo la mete en la cola equivocada. La severidad debería reflejar impacto potencial, no urgencia del equipo.
Tuning como proyecto único. Un ejercicio de depuración que se hace una vez y no se repite vuelve al mismo estado en pocos meses. El ciclo de revisión es parte del trabajo, no una campaña.
Perder trazabilidad de los cambios. Modificar reglas sin control de versiones ni registro de quién cambió qué y por qué hace imposible reconstruir por qué una alerta dejó de aparecer. Esto pesa especialmente cuando hay que justificar decisiones ante auditoría o ante un incidente posterior.
Límites reales. El tuning no elimina la necesidad de analistas, no sustituye la correlación con fuentes externas y no convierte un SIEM en un sistema de decisión automática. Tampoco garantiza cobertura: una regla silenciada es un punto ciego hasta que se revisa.
Criterio práctico para decidir cuándo ajustar, cuándo silenciar y cuándo retirar
La decisión sobre una regla ruidosa se puede ordenar con tres preguntas: ¿el evento sigue siendo relevante para la operación?, ¿el volumen se explica por cambios legítimos?, ¿existe una forma de conservar la señal reduciendo el volumen?
Con esas respuestas, el abanico se reduce a cuatro acciones:
Ajustar. Cuando el evento es relevante pero la regla dispara sobre casos que no lo son. Ejemplos típicos: agregar exclusiones por host o por usuario de servicio, refinar el patrón del decoder, subir el umbral de frecuencia para que la regla capture ráfagas y no eventos aislados. El ajuste preserva la detección y reduce el volumen.
Correlacionar. Cuando el evento individual no es accionable pero su repetición o su combinación con otros sí. En lugar de silenciar la regla base, se mantiene y se agrega una regla de correlación que dispare solo ante el patrón. Esto conserva la materia prima para investigación.
Silenciar con registro. Cuando el evento es esperado y no aporta valor operativo, pero se quiere conservar la posibilidad de reactivarlo. El silencio debe tener dueño, motivo y fecha de revisión. Si no hay fecha, no es silencio: es abandono.
Retirar. Cuando la regla ya no corresponde a nada en la infraestructura actual: un servicio que se dio de baja, un rango de red que se reasignó, una integración que se descontinuó. Retirar es distinto de silenciar: implica eliminar la regla y, si aplica, el decoder asociado.
Un criterio útil para no decidir en caliente: cualquier cambio sobre una regla de severidad alta debería pasar por revisión de una segunda persona. Los cambios sobre reglas de severidad baja pueden ser más ágiles, pero igualmente registrados.
Cómo evaluar este ciclo en una operación real
Llevar este ciclo a la práctica requiere tres cosas: visibilidad del comportamiento de las reglas, un responsable del tuning y una cadencia de revisión. La visibilidad se construye con reportes periódicos del top de reglas por volumen, distribución por host y tasa de cierre. El responsable puede ser interno o externo, pero debe existir. La cadencia puede ser mensual para reglas de alto volumen y trimestral para el resto.
Cuando la operación no tiene esa capacidad instalada, evaluar Wazuh como Servicio permite contrastar el estado actual del ruleset, la línea base de eventos y el criterio con que se toman las decisiones de ajuste, silencio o retiro. No se trata de delegar la decisión, sino de tener una referencia técnica sobre si el ciclo existe y funciona.
Preguntas útiles para diagnosticar el estado del tuning en la propia operación:
- ¿Sabemos cuáles son las diez reglas que más eventos generan esta semana?
- ¿Tenemos registro de la última vez que se revisó cada regla silenciada?
- ¿Existe una línea base documentada del volumen esperado por regla?
- ¿Los cambios sobre reglas pasan por control de versiones?
- ¿Podemos reconstruir por qué una alerta dejó de aparecer hace tres meses?
Si la mayoría de las respuestas es negativa, el problema no es Wazuh: es la ausencia de un ciclo de tuning. La herramienta seguirá generando eventos; la diferencia entre señal y ruido la define la operación que los interpreta.
Conversemos sobre cómo evaluar Wazuh como Servicio en tu operación.