Vector stores en RAG: qué se indexa, qué se recupera y qué medir
Criterios de diseño y operación para la capa de vector store en un RAG privado: fragmentación, metadatos, recuperación, trazabilidad y métricas observables.

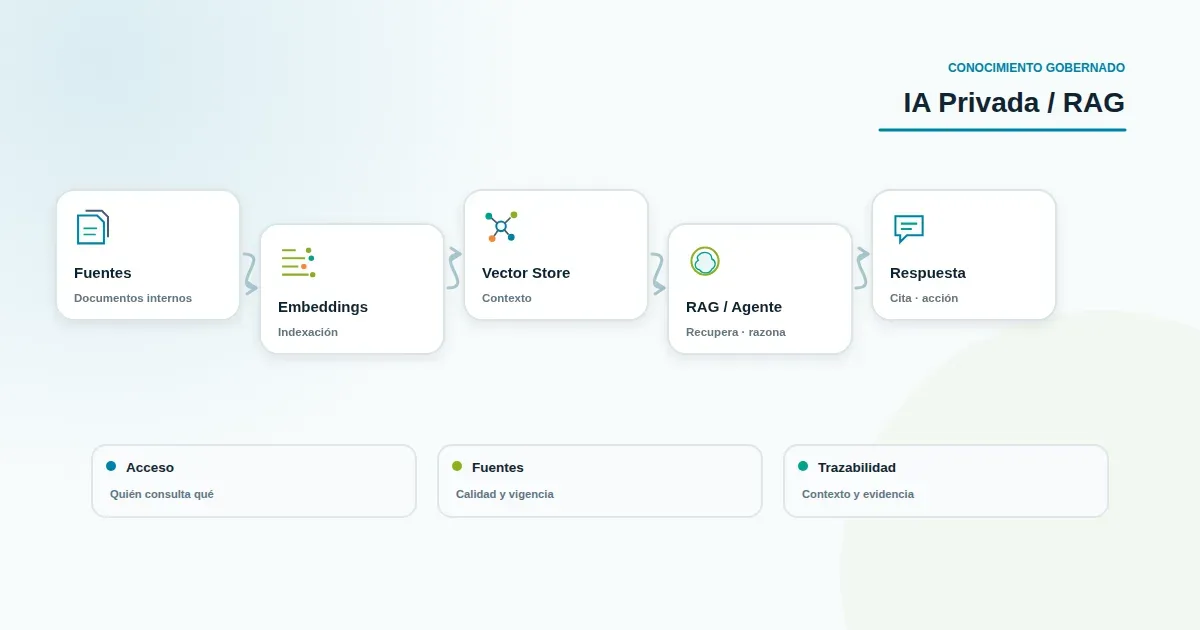
En un RAG privado, el vector store no es un repositorio pasivo: es la capa donde el conocimiento de la empresa se vuelve recuperable. Lo que se decide antes de insertar un solo embedding condiciona lo que el sistema podrá responder después. La pregunta operativa no es qué motor vectorial usar, sino qué documentos entran, cómo se fragmentan y con qué metadatos viajan.
Qué se indexa: decisiones sobre documentos empresariales antes de llegar al vector store
Unidad de fragmentación. El chunk es la unidad atómica de recuperación. Un chunk demasiado grande diluye la señal: el embedding promedia varios temas y la similitud deja de discriminar. Uno demasiado pequeño pierde contexto y produce fragmentos que, aislados, no responden nada. En documentación empresarial —procedimientos, contratos, políticas, manuales técnicos— suele funcionar mejor fragmentar por unidad semántica (sección, cláusula, paso) que por conteo fijo de caracteres, conservando un solapamiento controlado entre fragmentos contiguos para no cortar ideas a la mitad.
Metadatos mínimos. Sin metadatos, el vector store es una caja negra. Cada fragmento debería cargar al menos: origen (sistema o repositorio del que proviene), versión o fecha de vigencia, área o dominio responsable, clasificación de sensibilidad y un identificador que permita volver al documento fuente. Estos campos habilitan filtros, trazabilidad y depuración selectiva.
Qué excluir o tratar aparte. No todo el corpus merece el mismo tratamiento. Documentos con datos personales identificables, credenciales, información financiera sensible o material sujeto a restricciones contractuales deberían indexarse en colecciones separadas con controles de acceso propios, o quedar fuera del índice general. Los duplicados y las versiones obsoletas son otro problema silencioso: si conviven tres versiones de un procedimiento, el sistema puede recuperar la derogada con la misma confianza que la vigente.
La calidad del corpus es el techo de la calidad de la recuperación. Ningún re-ranking compensa de forma sostenible un índice poblado con material redundante, desactualizado o mal clasificado. Aquí la IA Privada · Agentes IA & RAG deja de ser una decisión de herramienta y pasa a ser una decisión de gobierno del conocimiento.
Qué se recupera: del embedding a la respuesta útil
La recuperación vectorial aproxima significado, no verdad. Un embedding coloca fragmentos y consultas en un espacio donde la cercanía indica similitud semántica, con consecuencias prácticas que conviene entender antes de confiar en el resultado.
Similitud vectorial y sus límites. La búsqueda por similitud es sólida para consultas conceptuales ("¿cómo se gestiona un incidente de severidad alta?") y débil para coincidencias exactas: códigos de ticket, números de contrato, identificadores de normativa, nombres propios poco frecuentes. Si la operación depende de recuperar un valor literal, la capa vectorial sola no basta; suele combinarse con búsqueda léxica.
Filtros por metadatos. Aplicar filtros antes o después de la búsqueda vectorial cambia el resultado. Filtrar por área, vigencia o sensibilidad reduce el espacio de candidatos y evita entregar contexto que el usuario no debería ver o que ya no está vigente. Un filtro mal diseñado puede dejar fuera el fragmento correcto y producir un "no encontrado" que en realidad es un problema de metadatos.
Re-ranking y selección de contexto. Recuperar diez fragmentos no significa entregar diez al modelo. El re-ranking reordena los candidatos según relevancia real para la consulta y la selección de contexto decide cuántos y cuáles entran en la ventana del modelo. Es una etapa de precisión, no de cobertura.
Cuándo falla la recuperación aunque el documento exista. Los falsos negativos son los casos más incómodos: el documento está en el índice, pero no se recupera. Ocurre por fragmentación que separó la respuesta de su contexto, por metadatos que excluyeron el fragmento, por vocabulario de la consulta que no coincide con el del documento, o por una versión obsoleta que desplazó a la vigente en el ranking. Diagnosticarlos exige poder inspeccionar qué se recuperó y por qué.
Qué conviene medir en operación
Medir un vector store no es medir el modelo. Son señales distintas y conviene no confundirlas.
Señales de recuperación. Relevancia del contexto entregado (evaluada con muestras revisadas, no solo con puntajes de similitud), cobertura de las consultas reales y tasa de casos sin resultado. Un aumento sostenido de consultas sin recuperación suele indicar un vacío en el corpus o un problema de fragmentación, no una falla del motor.
Señales de indexación. Frescura del índice respecto a las fuentes, duplicidad de fragmentos y documentos huérfanos —indexados pero ya inexistentes en el origen, o cuya fuente cambió sin que el índice se actualizara—. Estas señales se degradan lentamente y son las que más afectan la confianza del usuario a mediano plazo.
Trazabilidad. Poder responder "¿qué documento sustentó esta respuesta?" es requisito operativo, no lujo. Sin esa cadena no hay forma de auditar una respuesta incorrecta, corregir el corpus ni demostrar control ante una revisión interna.
Límites de las métricas. Los números no dicen si una respuesta es correcta, solo si el sistema se comporta de forma consistente. Una métrica de recuperación estable puede convivir con un corpus que se volvió obsoleto. La evaluación humana por muestreo sigue siendo necesaria; las métricas sirven para detectar tendencias y priorizar revisión.
Errores frecuentes y buenas prácticas
Indexar todo sin criterio. Volcar repositorios completos sin filtrar por vigencia, sensibilidad o permisos produce índices que recuperan material que no debería circular. La admisión al índice debería ser una decisión explícita, no un efecto secundario de conectar una carpeta.
Confundir volumen con calidad. Más documentos no mejora la recuperación; la ensucia si el material es redundante o contradictorio. Un corpus curado y pequeño suele superar a uno grande y desordenado.
Ignorar el mantenimiento. El índice envejece. Sin un proceso de reindexación ante cambios en las fuentes, el sistema responde con conocimiento caduco y el usuario pierde confianza antes de que el equipo lo note.
Buenas prácticas. Definir criterios de admisión por tipo de documento, separar colecciones por dominio y sensibilidad, establecer revisión periódica de vigencia y duplicados, y mantener la trazabilidad fragmento-documento como parte del diseño.
Criterio práctico para evaluarlo en una operación real
Antes de escalar un RAG privado, conviene responder algunas preguntas de diagnóstico:
- ¿Qué proporción del corpus indexado está vigente y es de fuente confiable?
- ¿Podemos reconstruir, para una respuesta dada, qué fragmentos la sustentaron y de qué documento provienen?
- ¿Tenemos visibilidad de las consultas que no recuperan nada?
- ¿Los filtros por área, vigencia y sensibilidad reflejan las reglas reales de acceso de la organización?
- ¿Existe un proceso definido para actualizar el índice cuando cambian las fuentes?
Si la mayoría de estas respuestas es "no" o "parcialmente", el problema no está en el motor vectorial sino en la capa de gobierno del conocimiento. Escalar un índice mal estructurado solo amplifica sus defectos.
Conversemos sobre cómo evaluar IA Privada · Agentes IA & RAG en tu operación.