Atribuir el origen de una caída: qué leer en la capa intermedia
La capa intermedia ve la petición, la llamada a la API y la consulta a la base de datos. Bien instrumentada, permite atribuir el origen de un síntoma con evidencia.
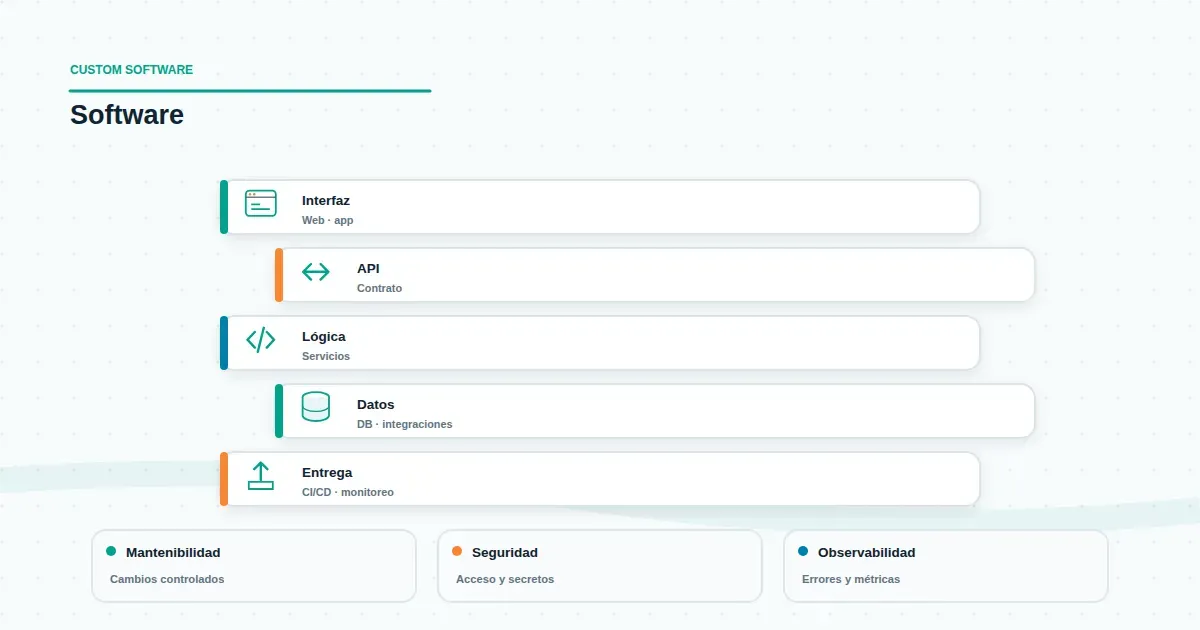
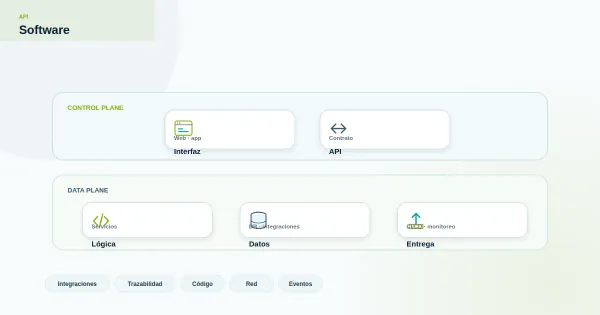
Una aplicación que responde lento es un síntoma, no un diagnóstico. Entre la queja del usuario y la causa raíz hay al menos tres extremos posibles —la aplicación, la API que consume y la base de datos que consulta— y el equipo de operaciones suele descubrirlo escalando entre áreas sin evidencia compartida. La capa intermedia, cuando está instrumentada, ocupa una posición que ningún otro componente replica: ve la petición que entra, la llamada que sale hacia la API y la consulta que llega a la base de datos. Ese privilegio no la convierte en culpable habitual, pero sí en el punto donde el flujo completo se puede leer.
Síntoma visible, origen incierto
Cuando la JVM se satura, los pools de conexiones se agotan o aparece un error de integración intermitente, la reacción instintiva es revisar el componente que reporta el error. Esa reacción suele ser equivocada. Un pool agotado en la capa intermedia puede deberse a consultas lentas en la base de datos que retienen conexiones más tiempo del previsto, a un timeout mal calibrado en la aplicación que aborta antes de liberar el recurso, o a un reintento automático que multiplica la carga sobre una dependencia ya degradada. El síntoma aparece en el middleware; el origen puede estar en cualquiera de los tres extremos.
La consecuencia operativa es concreta: sin evidencia que atraviese el flujo completo, el diagnóstico se convierte en una secuencia de suposiciones. El equipo de aplicaciones culpa a la base de datos, el de datos culpa a la API, y el de infraestructura reinicia servicios esperando que el síntoma desaparezca. Cada iteración consume tiempo de indisponibilidad y erosiona la confianza entre equipos.
La capa intermedia no resuelve ese problema por existir. Lo resuelve cuando emite señales que permiten reconstruir el recorrido de una petición específica y medir cuánto tiempo consume cada salto. Esa es la diferencia entre tener middleware y tener capacidad de diagnóstico.
Señales que permiten atribuir el origen
Tres familias de señales, bien configuradas, permiten triangular el origen de un síntoma sin inferencias:
Trazas con identificador de correlación. Cada petición que entra a la capa intermedia recibe un identificador que viaja hasta la base de datos y regresa con la respuesta. Si la traza muestra que el tiempo se consume entre la salida del middleware y la respuesta de la base de datos, el cuello de botella está en la consulta, en el plan de ejecución o en la red hacia ese extremo. Si se consume antes de que el middleware emita la llamada, el problema está en la aplicación o en la cola de entrada. Si se reparte entre la llamada a la API y la espera de su respuesta, el origen está en el servicio externo. La traza no adivina: muestra dónde se detuvo el reloj.
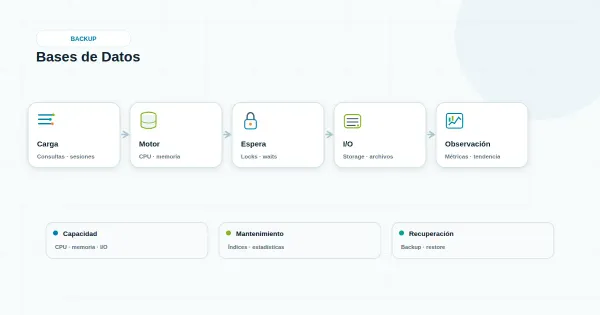
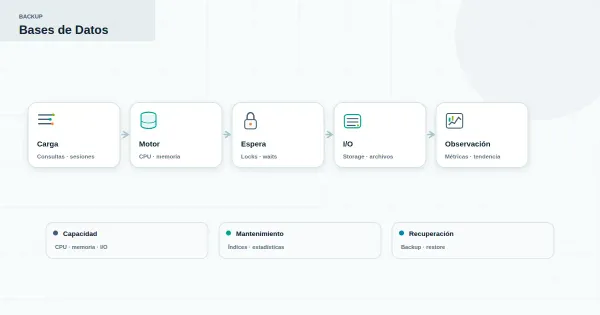
Métricas de pool e hilo. El número de conexiones activas, en espera y el tiempo medio para obtener una conexión indican dónde se acumula la presión. Un pool con conexiones activas al máximo y cola de espera creciente señala que la base de datos no libera conexiones al ritmo necesario o que el middleware las retiene más allá de la operación. Los hilos bloqueados en espera de respuesta apuntan a timeouts inconsistentes o a dependencias externas lentas. Estas métricas no explican la causa, pero acotan el extremo donde buscar.
Logs con contexto de flujo. Un error de integración aislado dice poco. Uno que aparece siempre tras un tiempo de espera específico, o que se correlaciona con un pico de latencia en la base de datos, sí. La capa intermedia puede registrar el tiempo de cada salto y el estado de la dependencia en el momento del fallo, lo que permite distinguir entre un payload inválido originado en la aplicación, una respuesta inesperada de la API y un timeout o bloqueo en la base de datos.
Estas señales no reemplazan la instrumentación de la aplicación ni de la base de datos: la complementan. Su valor está en la correlación. Una métrica de pool aislada es un dato; la misma métrica junto a la traza de la petición que la saturó y al log del error que la acompañó es evidencia.
Dependencias que distorsionan la lectura
Instrumentar no garantiza leer bien. Hay dependencias estructurales que alteran la interpretación de las señales y conviene tener presentes antes de atribuir un origen:
- Timeouts en cascada. Si el timeout de la aplicación es menor que el del middleware, y este menor que el de la base de datos, la aplicación aborta antes de que la capa intermedia registre el error. El resultado es un error visible en la aplicación sin evidencia en el middleware. La ausencia de señal no significa ausencia de problema: puede significar que el observador se apagó antes de que el fallo se manifestara.
- Reintentos que amplifican. Un reintento automático ante un timeout puede duplicar la carga sobre una dependencia ya lenta. La traza mostrará varias peticiones donde el usuario percibió una; sin ese contexto, la métrica de pool parecerá desproporcionada respecto al tráfico real.
- Transformación de payloads. Un middleware que transforma mensajes introduce latencia de CPU y puede generar errores de formato que la aplicación no ve. Esa latencia aparece en la traza como tiempo consumido en la capa intermedia, no en los extremos, y puede confundirse con un problema de capacidad.
- Estado compartido. Si la capa intermedia mantiene caché, sesiones o colas internas, su comportamiento bajo fallo parcial determina si el flujo se degrada o se detiene. La lectura de señales debe considerar ese estado, no solo el tránsito.
Reconocer estas dependencias evita una conclusión frecuente y errónea: atribuir al middleware un problema que él solo está atravesando.
Preguntas para evaluar la capacidad de diagnóstico
La evaluación de la arquitectura no debería centrarse en el producto ni en la versión, sino en su capacidad de hacer observable el flujo que transporta. Cuatro preguntas operativas orientan esa evaluación:
- ¿Podemos reconstruir el recorrido completo de una petición lenta con evidencia de cada salto? Si la respuesta es no, existe un punto ciego que se traducirá en tiempo de diagnóstico perdido cada vez que aparezca un síntoma.
- ¿Las métricas de pool, hilo y timeouts están disponibles donde se consultan las de la aplicación y la base de datos? La correlación manual entre fuentes dispersas es lenta y propensa a error; integrar señales acorta el tiempo entre detección y localización.
- ¿Los timeouts y reintentos están calibrados de forma coherente en toda la cadena? Una cadena con timeouts inconsistentes produce errores visibles en un extremo y silenciosos en el otro, lo que invalida la lectura de señales.
- ¿El equipo sabe qué señal consultar primero ante cada tipo de síntoma? La instrumentación sin criterio de lectura genera dashboards que nadie interpreta bajo presión.
Responder estas preguntas no exige una transformación inmediata. Exige reconocer que la capa intermedia, además de transportar peticiones, es el punto donde la operación puede leer el estado del flujo completo. Esa lectura es la base para decidir si el problema se resuelve en la aplicación, en la API, en la base de datos o en la propia capa intermedia, y para dejar de escalar a ciegas.
Si tu equipo está evaluando cómo reducir el tiempo entre la detección de un síntoma y la identificación de su origen, podemos revisar juntos el rol del middleware en tu arquitectura y qué señales conviene instrumentar primero.
Revisemos qué señales conviene instrumentar en tu capa intermedia.