Capacidad en virtualización: leer CPU, memoria y storage como un sistema
Leer CPU, memoria y storage como un sistema permite interpretar señales de capacidad en virtualización antes de concluir que el hardware es el problema.
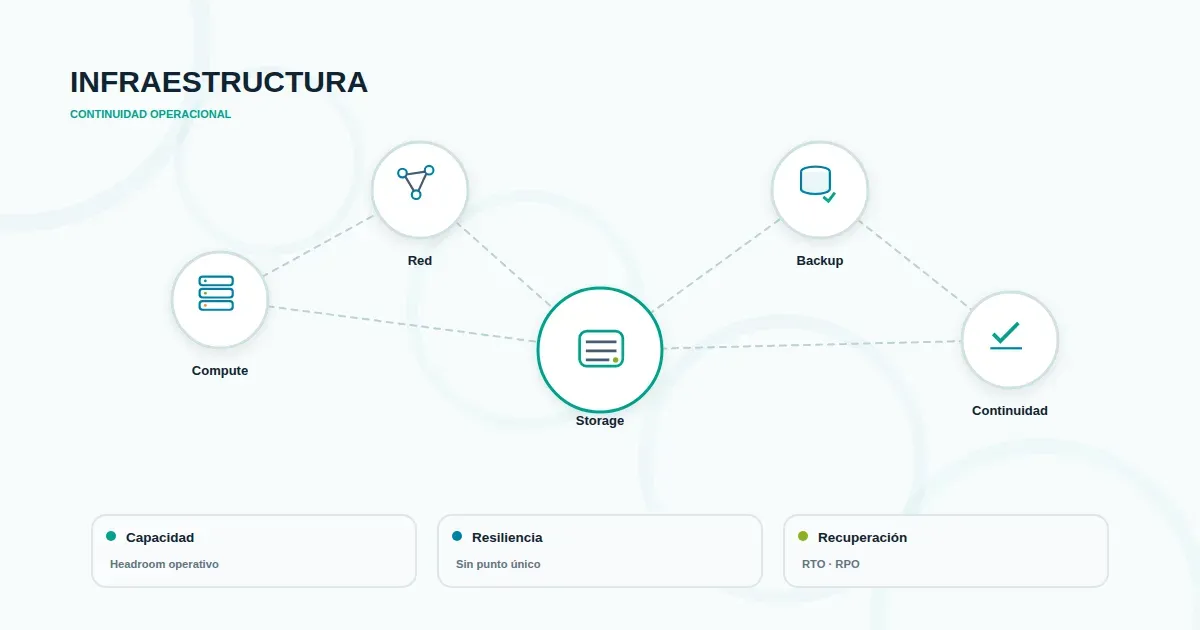
En una plataforma virtualizada, la pregunta "¿nos falta hardware?" casi nunca se responde mirando un solo indicador. Un host con CPU al 40 % puede estar ahogando cargas por presión de memoria; un datastore con latencia alta puede degradar aplicaciones que parecen limitadas por procesamiento. La capacidad no es la suma de tres umbrales independientes, sino la lectura conjunta de cómo se condicionan entre sí.
Este artículo no trata sobre cómo decidir una compra ni sobre qué métricas configurar. Trata sobre cómo interpretar las señales que ya existen en la plataforma antes de concluir que el hardware es el problema.
Qué significa evaluar capacidad en una plataforma virtualizada (CPU, memoria y storage como un solo sistema)
En un entorno virtualizado, los recursos físicos se reparten entre máquinas virtuales mediante un hipervisor que arbitra acceso a CPU, memoria y almacenamiento. Esa mediación introduce efectos que no existen en servidores dedicados: colas de programación, mecanismos de recuperación de memoria, cachés compartidas y límites impuestos por configuración.
Evaluar capacidad significa entender cómo interactúan esos tres recursos bajo la carga real de la operación. Algunos acoplamientos que conviene tener presentes:
- Presión de memoria que se convierte en carga de CPU. Cuando un host agota memoria física, el hipervisor puede recurrir a ballooning, compresión o swap a nivel de host. Cualquiera de ellos consume ciclos de CPU y degrada la latencia de las VM afectadas. Un pico de CPU puede ser, en realidad, un síntoma de memoria insuficiente.
- Storage lento que parece problema de CPU. Una VM que espera operaciones de disco acumula tiempo en estado de espera. Si solo se mira el porcentaje de CPU del guest, la aplicación parece "lenta" sin causa aparente. La causa está en IOPS insuficientes o latencia elevada del datastore.
- Sobreasignación que distorsiona la lectura. Los ratios de vCPU por núcleo físico y de memoria asignada por memoria física determinan cuánta contención potencial existe. Un host con utilización baja pero sobreasignación alta puede colapsar ante un evento de demanda simultánea.
La capacidad se evalúa como una propiedad del conjunto: qué margen real existe para absorber variación sin que un recurso arrastre a los otros. Esa lectura permite distinguir entre una plataforma sana con picos normales y una que ya está al límite aunque sus promedios se vean cómodos.
Señales que conviene observar de forma sostenida y por qué aislarlas engaña
La observabilidad de capacidad requiere series temporales, no capturas puntuales. Un promedio de 24 horas puede ocultar episodios de saturación en ventanas específicas —cierre de mes, respaldos, replicación— que son precisamente los que afectan la operación.
En CPU: además de la utilización del host, importa la CPU ready time (tiempo que una vCPU espera para ser programada) y la longitud de cola. Un host al 60 % con ready time elevado en ciertas VM indica contención, no holgura. También importa la distribución: un promedio bajo puede esconder núcleos saturados por una VM con muchas vCPU mal dimensionada.
En memoria: el porcentaje consumido es solo el punto de partida. Interesan el ballooning activo, la compresión y el swap a nivel de host. Cualquiera de estos mecanismos indica que la memoria física ya no alcanza y el hipervisor está recuperando. Un host al 85 % sin ballooning es distinto de uno al 85 % con ballooning sostenido: el segundo ya paga un costo de rendimiento.
En storage: la latencia por datastore y por VM, las IOPS efectivas frente a las demandadas y la profundidad de cola. Un datastore con latencia creciente en horario laboral, aunque las IOPS estén dentro de lo esperado, puede mostrar contención en el backend físico. El espacio utilizado conviene observarlo como tendencia, no como foto del día.
En el conjunto: la correlación temporal entre indicadores. Si los picos de ready time coinciden con episodios de ballooning, el problema es de memoria, no de CPU. Si la latencia de storage sube cuando aumenta la carga de una VM específica, el cuello de botella está en el acceso a disco de esa carga.
Aislar cualquiera de estas señales lleva a conclusiones equivocadas. El valor está en la lectura cruzada y en la comparación contra la línea base histórica de la propia plataforma, no contra referencias externas.
Errores frecuentes al interpretar utilización, sobreasignación y picos
Algunos patrones que suelen distorsionar la lectura de capacidad:
Confundir utilización con capacidad disponible. Un host al 70 % de CPU no tiene un 30 % libre en términos prácticos: parte de ese margen se consume en absorber variación y en la operación del hipervisor. La capacidad útil es menor que la aritmética simple sugiere.
Ignorar la sobreasignación al leer promedios. Si un host tiene 40 vCPU asignadas sobre 16 núcleos físicos, la utilización promedio puede verse baja porque las VM no demandan al mismo tiempo. Pero la capacidad de absorber un evento de demanda concurrente es limitada. La sobreasignación no es un error en sí; el error es no saber cuánta contención potencial existe.
Tratar los picos como anomalías a eliminar. Ciertos picos son parte del funcionamiento normal: respaldos nocturnos, procesos batch, ventanas de replicación. La pregunta no es cómo eliminarlos, sino si la plataforma los absorbe sin degradar la operación concurrente. Un pico que afecta la latencia de otras VM sí es una señal de capacidad.
Leer el storage solo por espacio libre. El espacio es el indicador más visible y el menos informativo sobre rendimiento. Un datastore con 40 % libre puede estar saturado en IOPS. El crecimiento del espacio importa para planificación; la latencia y las IOPS, para el diagnóstico operativo.
Atribuir lentitud de aplicación a la plataforma sin descartar el guest. Una VM mal dimensionada —demasiadas vCPU, poca memoria, discos con configuración inadecuada— puede generar síntomas que parecen del host. Antes de concluir que la plataforma está al límite, conviene revisar la configuración de las cargas.
Medir en el momento equivocado. Una captura durante un incidente muestra el síntoma, no la tendencia. La lectura de capacidad requiere series que cubran al menos un ciclo operativo completo, incluyendo los eventos periódicos que la plataforma ya conoce.
Criterio práctico para interpretar la capacidad de la plataforma
La lectura conjunta se sostiene sobre algunos hábitos que conviene adoptar antes de sacar conclusiones:
- Establecer la línea base. Documentar el comportamiento típico de CPU, memoria y storage en un periodo representativo, incluyendo los picos conocidos. Sin línea base, cualquier lectura es relativa a nada.
- Identificar el recurso que arrastra a los demás. Si el ready time alto coincide con ballooning, el recurso limitante es memoria. Si la latencia de storage crece con la carga, el limitante es almacenamiento. La lectura debe apuntar al recurso que origina la degradación, no al que la manifiesta.
- Revisar la configuración de las cargas. Ratios de sobreasignación, dimensionamiento de vCPU y memoria por VM, ubicación de datastores, políticas de respaldo que compiten con la operación. Con frecuencia hay margen de ajuste que la lectura de señales permite identificar sin intervención sobre el hardware.
- Leer la tendencia, no el punto. Si el recurso limitante muestra crecimiento sostenido en la serie histórica, la señal es clara. Si la tendencia es estable y los picos son absorbidos, la plataforma está operando dentro de su margen.
- Considerar el impacto en resiliencia. La capacidad no es solo rendimiento: un host con margen insuficiente reduce la capacidad de absorber la caída de otro host, afecta ventanas de respaldo y limita la recuperación ante incidentes. Esa dimensión también forma parte de la lectura de capacidad.
Este criterio se apoya en la observabilidad sostenida y en la interpretación conjunta. La lectura de señales es la que da sustento a cualquier conclusión posterior sobre la plataforma. Si la operación requiere una revisión estructurada de la plataforma, el equipo de Infraestructura & Virtualización puede acompañar ese análisis con foco en la lectura de señales y en el dimensionamiento.
Para profundizar en los marcos de decisión y en las métricas de evaluación, los artículos Capacidad en virtualización: cómo saber si necesitas ampliar hardware y Evaluación de capacidad en virtualización: métricas que evitan compras innecesarias complementan este enfoque desde el ángulo de la decisión y del catálogo de indicadores.
Conversemos sobre cómo evaluar Infraestructura & Virtualización en tu operación.