Mantenimiento DBA: qué tareas automatizar y cuáles exigen criterio
Cómo repartir el mantenimiento DBA entre automatización y criterio humano: señales técnicas, tareas que exigen juicio y errores frecuentes.
En una operación con bases de datos SQL Server, buena parte del mantenimiento se puede programar. Otra parte no. La dificultad no está en ejecutar tareas, sino en decidir cuáles pueden delegarse a un job y cuáles deben pasar por juicio humano antes de tocar producción. Esa frontera marca la diferencia entre un mantenimiento suficiente y uno que acumula deuda técnica silenciosa.
Este artículo no es un catálogo de tareas ni una comparación de herramientas. Es un criterio operativo para repartir responsabilidades entre automatización y criterio experto, en el contexto de la Administración de Bases de Datos DBA.
Qué implica decidir entre automatizar y aplicar criterio en mantenimiento DBA
Automatizar no es "dejar que el sistema se mantenga solo". Es trasladar una decisión recurrente a una regla que se ejecuta sin supervisión. Eso funciona cuando la tarea cumple tres condiciones:
- Es repetitiva y predecible en su ejecución.
- Su resultado correcto se puede verificar de forma objetiva.
- El contexto de negocio no cambia la forma correcta de hacerla.
Cuando falta alguna, la automatización no elimina el trabajo: lo desplaza. El job se ejecuta igual, pero la decisión que debía tomarse antes o después queda sin dueño. Ahí aparecen los problemas típicos: índices que se reconstruyen cuando no corresponde, estadísticas actualizadas en ventanas que compiten con la carga, backups que se completan pero nunca se validan.
El criterio de reparto no es "lo simple se automatiza y lo complejo se hace a mano". Es más preciso: se automatiza lo que tiene una respuesta correcta verificable; se reserva criterio para lo que exige interpretar contexto, impacto o intención.
Señales técnicas que indican cuándo una tarea es automatizable
Hay indicadores concretos para clasificar una tarea como candidata a automatización. No son absolutos, pero orientan bien.
Frecuencia y estabilidad. Si la tarea se ejecuta con la misma periodicidad y su ventana no cambia según la carga del negocio, es candidata. Backups completos, diferenciales y de log; verificación de integridad con DBCC CHECKDB; recolección de métricas de espacio y crecimiento.
Resultado binario o medible. La tarea produce un estado comprobable sin ambigüedad: el backup existe y su RESTORE VERIFYONLY pasa; el job terminó con código 0; el archivo de log creció dentro del umbral definido. Si el resultado correcto depende de interpretación, no es automatizable de punta a punta.
Bajo acoplamiento con la carga transaccional. Reindexar o actualizar estadísticas en horarios de baja actividad es una decisión de calendario, no de criterio por ejecución. Una vez definida la ventana, el job puede correr solo. Lo que sí requiere criterio es qué se reindexa y con qué umbral de fragmentación, y eso se define una vez, no en cada ejecución.
Alertas con umbrales claros. Cuando el criterio de "esto está mal" se expresa como una condición numérica (espacio libre bajo X, duración de job sobre Y, esperas por bloqueo sobre Z), la detección se automatiza. La respuesta a la alerta, no necesariamente.
Un punto que suele pasarse por alto: automatizar la detección es distinto de automatizar la acción. Muchas tareas se benefician de tener detección automática y acción manual. Esa separación es, en la práctica, la decisión más útil que puede tomar un equipo de operaciones.
Tareas que requieren criterio humano y por qué
Hay tareas donde la automatización puede ejecutar, pero no debería decidir.
Reindexado y reconstrucción de índices. El umbral de fragmentación es una convención, no una verdad. Un índice muy fragmentado en una tabla pequeña puede no justificar reconstrucción; uno poco fragmentado en una tabla enorme y caliente puede requerir intervención por otros motivos. Además, la reconstrucción bloquea o consume recursos según el edition, el tipo de índice y la ventana disponible. La ejecución puede ser automática; la política, no.
Actualización de estadísticas. El auto-update cubre muchos casos, pero no todos. En tablas con distribución sesgada, en columnas con correlación, o cuando el plan cambia por umbrales de modificación, forzar una actualización con FULLSCAN requiere entender el patrón de consulta. Automatizarlo sin ese análisis puede empeorar planes en lugar de mejorarlos.
Gestión de crecimiento de archivos y logs. El crecimiento automático es una red de seguridad, no una estrategia. Decidir tamaño inicial, incremento y si conviene pre-crecer antes de una carga masiva depende del negocio. Un job que "arregla" el crecimiento sin contexto puede enmascarar un problema de diseño.
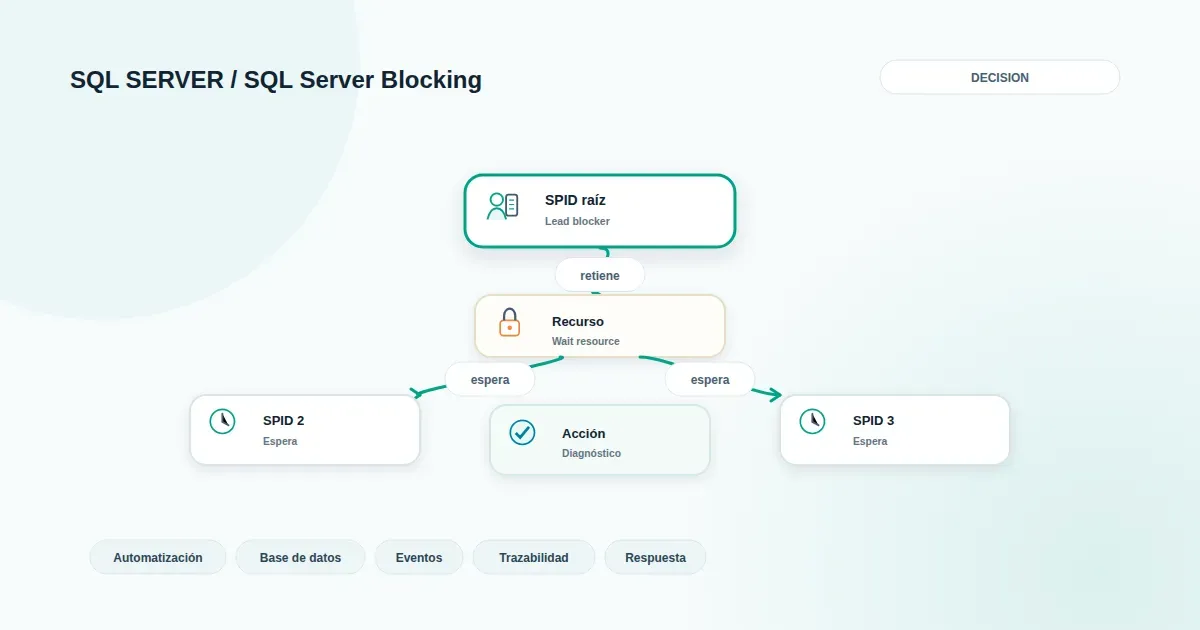
Resolución de bloqueos y deadlocks. Detectar un deadlock es automático. Decidir si se cambia un índice, se reescribe una consulta, se ajusta el nivel de aislamiento o se modifica la lógica de la aplicación, no lo es. Esa decisión se apoya en diagnóstico, y el diagnóstico no se delega a un job.
Ventanas de mantenimiento en sistemas con SLA estricto. Cuándo intervenir, cuánto puede durar la interrupción y qué se prioriza si algo sale mal son decisiones de negocio. La automatización ejecuta dentro de la ventana; no la define.
Retención y purga de datos. Cuánto tiempo se conserva un backup, un log o un histórico depende de requisitos operacionales, contractuales y de preparación ante normativas como la Ley 21.719. Esa preparación implica controles y trazabilidad; no se resuelve con un job de borrado.
Errores frecuentes al automatizar mantenimiento sin criterio
Los problemas no suelen venir de la tarea mal ejecutada, sino de la decisión mal delegada.
Automatizar la acción sin automatizar la verificación. Un backup que se ejecuta todos los días y nunca se restaura en un entorno de prueba no es un backup: es una expectativa. La verificación es parte de la tarea, no un extra.
Confundir "sin errores" con "correcto". Un job que termina con código 0 puede haber hecho exactamente lo que no correspondía. Reindexar todo cada noche sin evaluar impacto es un ejemplo clásico.
Acumular jobs sin dueño. Con el tiempo, los jobs se multiplican y nadie recuerda por qué existe cada uno. Cuando algo falla, no hay mapa. Documentar el por qué de cada job es tan importante como el job mismo.
Ignorar el efecto sobre la carga. Una ventana de mantenimiento que se solapa con procesos de negocio puede generar lentitud percibida por usuarios, y esa lentitud se atribuye a la aplicación, no al job. La coordinación entre mantenimiento y operación es parte del diseño.
Automatizar la respuesta a incidentes. Reiniciar un servicio, matar una sesión o forzar un failover de forma automática ante una alerta puede resolver el síntoma y destruir la evidencia necesaria para resolver la causa. En continuidad y ciberseguridad, la trazabilidad importa.
Cómo evaluar el reparto en una operación real
Una forma práctica de revisar el reparto actual es clasificar cada tarea en una matriz de dos ejes: frecuencia y necesidad de contexto.
- Alta frecuencia, bajo contexto: candidata clara a automatización con verificación. Backups, checkdb, recolección de métricas.
- Alta frecuencia, alto contexto: automatizar la ejecución, mantener la política bajo revisión periódica. Reindexado, estadísticas.
- Baja frecuencia, bajo contexto: automatizar con alerta. Limpieza, rotación de archivos.
- Baja frecuencia, alto contexto: mantener bajo criterio explícito. Cambios de configuración, ajustes de capacidad, resolución de incidentes.
El ejercicio útil no es llenar la matriz, sino responder tres preguntas por cada tarea:
- ¿Cuál es el resultado correcto y cómo lo verifico sin intervención humana?
- Si el job falla o produce un resultado inesperado, ¿quién se entera y en cuánto tiempo?
- ¿La decisión de ejecutar esta tarea cambia según el contexto del negocio?
Si la respuesta a la primera es vaga, la tarea no está lista para automatizarse. Si la respuesta a la segunda es "nadie", el problema no es la automatización sino la observabilidad. Si la respuesta a la tercera es "sí", la ejecución puede automatizarse pero la política no.
Para una revisión más estructurada del alcance de mantenimiento, el checklist técnico de servicio DBA SQL Server para gerentes TI en Chile ofrece un punto de partida para contrastar lo que hoy está cubierto y lo que no.
Cierre
El mantenimiento DBA no se resuelve eligiendo entre automatizar o no. Se resuelve decidiendo, tarea por tarea, dónde termina la regla y dónde empieza el criterio. Las operaciones que lo hacen bien no tienen más jobs que las demás: tienen jobs con dueño, con verificación y con política documentada. Las que lo hacen mal suelen tener automatización abundante y mantenimiento insuficiente, la combinación más costosa cuando aparece una indisponibilidad.
Conversemos sobre cómo evaluar Administración de Bases de Datos DBA en tu operación.