Middleware: retención de conexiones y agotamiento de pools
Guía técnica para distinguir si un pool agotado se debe a falta de capacidad o a retención anómala de conexiones en la capa middleware.
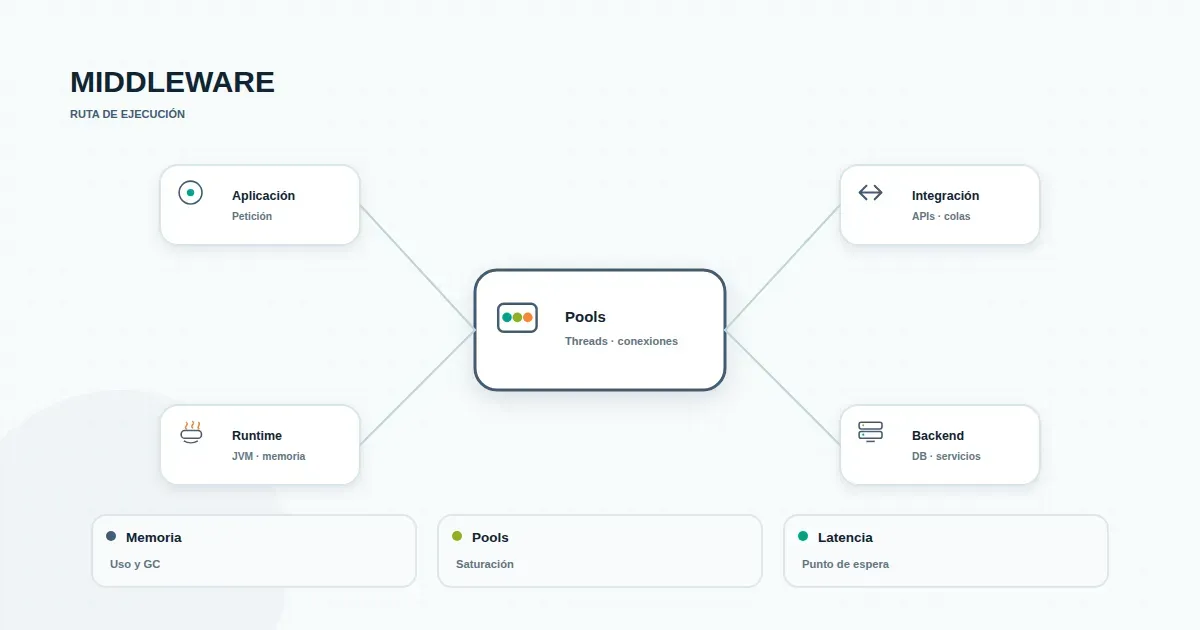
Cuando una aplicación responde lento, los pools de conexión se agotan o aparecen errores de integración sin cambios evidentes en el código, la discusión suele derivar hacia la misma pregunta: ¿el problema está en la aplicación, en la base de datos o en la capa que los conecta? En muchos incidentes reales, la causa no es la falta de capacidad del motor de base de datos ni un bug en la aplicación, sino una retención anómala de conexiones en la capa middleware: conexiones que se toman y no se devuelven al pool en el tiempo esperado, o que se devuelven en un estado que impide su reutilización. Este artículo no trata sobre qué es el middleware ni sobre su rol general entre aplicaciones, APIs y bases de datos, sino sobre un patrón de fallo concreto y cómo diagnosticarlo.
Por qué el pool se agota aunque la base de datos esté sana
Un pool de conexiones es un recurso finito con un límite configurado. Cuando ese límite se alcanza y todas las conexiones están en uso, las solicitudes entrantes esperan. Si la espera supera el timeout configurado, la solicitud falla con un error de integración. El síntoma visible es "pool agotado", pero la causa puede estar en varios lugares distintos.
La confusión habitual es asumir que un pool agotado significa que la base de datos no da abasto. En la práctica, hay al menos tres escenarios que producen el mismo síntoma con causas muy diferentes:
- Carga legítima superior a la capacidad del pool: la concurrencia real supera el límite configurado. Es un problema de dimensionamiento, no de retención.
- Consultas lentas que retienen la conexión: la conexión se toma correctamente, pero la operación tarda más de lo previsto y la conexión permanece ocupada. La causa está en la consulta o en la base de datos.
- Retención anómala en el middleware: la conexión se toma, la operación termina, pero la conexión no se devuelve al pool —o se devuelve tarde— por un error en el manejo del ciclo de vida. La causa está en la capa intermedia.
Distinguir estos tres escenarios es el primer paso. El síntoma es idéntico; el diagnóstico y la solución no lo son.
Patrones de retención anómala en la capa middleware
La retención anómala de conexiones rara vez es un bug evidente. Suele ser el resultado de patrones de implementación que funcionan bajo carga baja pero se degradan bajo concurrencia.
Falta de liberación en rutas de error. El patrón más común: la conexión se adquiere al inicio de un bloque, se libera al final del camino feliz, pero si ocurre una excepción en el medio, la liberación no se ejecuta. Bajo carga baja, las excepciones son raras y el pool se recupera. Bajo carga alta, las excepciones se multiplican y las conexiones se acumulan sin devolverse.
Transformaciones costosas con la conexión tomada. Si el middleware transforma el resultado de una consulta mientras mantiene la conexión abierta, el tiempo de retención incluye el tiempo de transformación. Una transformación que tarda 200 ms por registro, aplicada a un resultado de 500 registros, retiene la conexión durante 100 segundos. La base de datos ya terminó su trabajo; la conexión sigue ocupada.
Orquestación secuencial con conexiones abiertas. Cuando el middleware coordina varias llamadas —por ejemplo, consultar un servicio, luego otro, luego escribir en base de datos— y mantiene la conexión a base de datos abierta durante toda la orquestación, el tiempo de retención incluye el tiempo de todas las llamadas intermedias. Si un servicio externo tarda, la conexión a base de datos espera sin hacer nada.
Reintentos que no liberan antes de reintentar. Un middleware que reintenta una operación fallida sin liberar la conexión anterior antes de adquirir una nueva duplica el consumo de conexiones por operación. Bajo carga, esto agota el pool rápidamente.
Timeouts mal alineados. Si el timeout de la operación en el middleware es mayor que el timeout del pool, las conexiones se retienen más allá de lo que el pool puede tolerar. La operación eventualmente falla, pero la conexión ya consumió su cupo durante todo ese tiempo.
Señales operativas que apuntan a retención y no a capacidad
La diferencia entre "el pool es demasiado pequeño" y "las conexiones se retienen demasiado tiempo" se puede observar con métricas concretas. No requiere instrumentación compleja, pero sí requiere mirar las métricas correctas.
| Señal | Lectura si es capacidad | Lectura si es retención |
|---|---|---|
| Conexiones activas | Altas de forma sostenida y proporcional a la carga | Altas incluso cuando la carga baja, o crecen sin correlación con solicitudes |
| Tiempo de espera para obtener conexión | Aumenta con la carga | Aumenta de forma desproporcionada respecto al aumento de carga |
| Tiempo de retención por conexión | Estable y cercano al tiempo de consulta | Crece con el tiempo, o tiene cola larga de valores altos |
| Conexiones activas vs. consultas en ejecución en la base de datos | Correlacionadas | Desacopladas: hay conexiones activas en el middleware sin consultas activas en la base de datos |
| Recuperación tras caída de carga | Rápida | Lenta: las conexiones tardan en volver al pool |
La señal más reveladora es la descorrelación entre conexiones activas en el middleware y consultas activas en la base de datos. Si el middleware reporta 50 conexiones activas y la base de datos reporta 5 consultas en ejecución, hay 45 conexiones retenidas sin trabajo real. Eso no es un problema de capacidad; es un problema de ciclo de vida.
Otra señal útil es la distribución del tiempo de retención, no solo el promedio. Un promedio de 50 ms puede esconder una cola de conexiones retenidas durante 30 segundos. Si solo se monitorea el promedio, el problema es invisible hasta que el pool se agota.
Cómo acotar el diagnóstico antes de tocar la configuración
El reflejo habitual ante un pool agotado es aumentar el límite. Eso puede aliviar el síntoma temporalmente, pero si la causa es retención, el problema reaparece cuando la carga crece lo suficiente para volver a llenar el pool ampliado. El diagnóstico debería preceder al ajuste.
Un orden razonable:
- Confirmar la descorrelación. Comparar conexiones activas en el middleware con consultas activas en la base de datos en la misma ventana de tiempo. Si no correlacionan, la causa está en el middleware.
- Identificar las rutas con mayor retención. No todas las operaciones retienen igual. Medir tiempo de retención por ruta o por tipo de operación permite ubicar los patrones problemáticos.
- Revisar el manejo de errores. Verificar que toda ruta de excepción libere la conexión. Es el patrón más común y el más fácil de corregir.
- Revisar el alcance de la conexión. Confirmar que la conexión no se mantiene abierta durante transformaciones, orquestaciones o llamadas a servicios externos que no la necesitan.
- Alinear timeouts. Verificar que el timeout de operación en el middleware sea menor o igual al timeout del pool, para que una operación lenta no consuma una conexión más allá de lo tolerable.
- Solo entonces, dimensionar. Si tras corregir la retención el pool sigue agotándose bajo carga legítima, el ajuste de límite es la respuesta correcta.
Este orden importa porque cada paso descarta una hipótesis. Aumentar el pool sin descartar retención es posponer el diagnóstico, no resolverlo.
Qué observar de forma continua
Una vez identificada y corregida la causa, la pregunta es qué monitorear para detectar una reaparición temprana. Las métricas que mejor discriminan entre capacidad y retención son:
- Conexiones activas vs. consultas activas en base de datos, en la misma ventana temporal.
- Distribución del tiempo de retención (percentiles, no solo promedio).
- Tasa de errores por ruta, para detectar rutas de excepción que no liberan.
- Tiempo de espera para obtener conexión, como indicador adelantado de saturación.
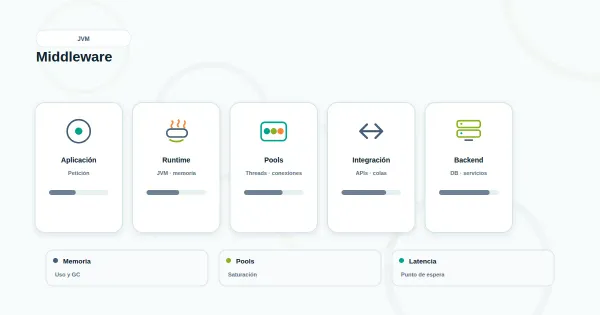
- Heap y garbage collector, si el middleware corre sobre JVM: la retención de conexiones suele acompañarse de retención de objetos asociados.
La combinación de estas señales permite distinguir, en el momento del incidente, si el problema es de capacidad o de ciclo de vida. Esa distinción es la que evita el ciclo de ampliar el pool, ver alivio temporal y volver al mismo punto.
Si tu operación presenta pools agotados, latencia creciente o errores de integración recurrentes sin cambios en la aplicación, vale la pena revisar cómo está gestionada la capa Middleware y si el ciclo de vida de las conexiones está bajo control.
Revisemos juntos el ciclo de vida de conexiones en tu capa middleware.