Middleware: aislamiento, dimensionamiento y timeouts en la capa intermedia
Cómo evaluar la capa de middleware como decisión de arquitectura: aislamiento de flujos, dimensionamiento de pools y JVM, y alineación de timeouts entre capas.
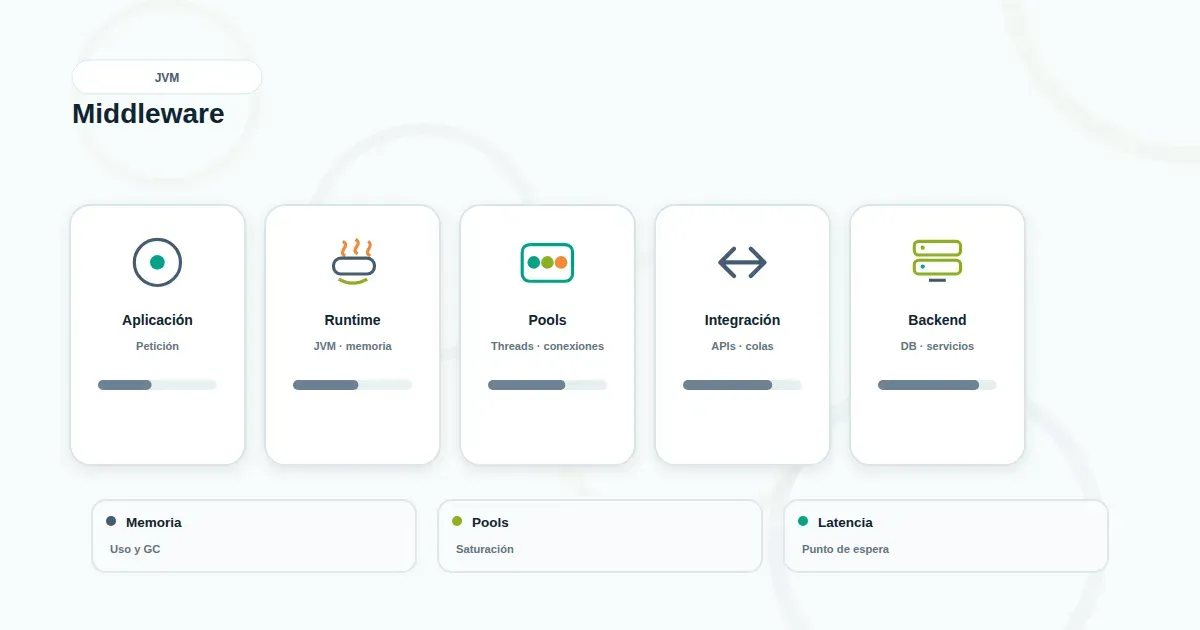
Hay un patrón que se repite en operaciones donde la capa de mediación ya está consolidada: nadie discute su función, pero pocos tienen criterios explícitos para decidir cómo aislarla, cómo dimensionarla y cómo alinear sus tiempos con el resto del stack. El resultado aparece como latencia, saturación de JVM, pools agotados, errores de integración y aplicaciones inestables. No es un problema de concepto, es un problema de decisiones de arquitectura que quedaron implícitas.
Este artículo no explica qué es el middleware ni recorre su rol como capa de integración. Asume ese contexto como conocido y trabaja sobre un plano distinto: qué decisiones de aislamiento, dimensionamiento y alineación de tiempos conviene tomar explícitamente, y cómo se manifiestan cuando se dejan al azar.
Por qué el aislamiento es una decisión, no un detalle de configuración
En muchas operaciones, flujos con perfiles de carga muy distintos comparten los mismos recursos: el mismo pool de conexiones, el mismo conjunto de hilos, la misma JVM, los mismos timeouts. Mientras el volumen es bajo, la convivencia no genera problemas visibles. Cuando uno de esos flujos crece o se degrada, arrastra a los demás.
El aislamiento no es una optimización de rendimiento. Es una decisión de arquitectura que define qué falla junto y qué no. Sin ella, un proceso batch pesado puede consumir el pool que necesita una API transaccional; una integración con un proveedor externo lento puede ocupar hilos que otra ruta requiere; una consulta mal optimizada puede presionar el heap y afectar a todo lo que corre en la misma instancia.
Los patrones de aislamiento más habituales en la capa de mediación son acotados y conocidos:
- Pools separados por criticidad. Un pool dedicado para flujos transaccionales y otro para procesos batch o integraciones no críticas. El costo es mayor consumo de conexiones; el beneficio es que un flujo no puede agotar el recurso del otro.
- Grupos de hilos diferenciados. Separar la atención de rutas críticas de las rutas de menor prioridad evita que una ruta lenta monopolice la capacidad de procesamiento.
- Circuit breakers por dependencia. Aislar el fallo de un proveedor externo para que no se propague al resto del flujo. Sin este aislamiento, un backend lento se convierte en una caída general.
- Instancias o despliegues separados. Cuando el aislamiento lógico no es suficiente, separar físicamente los flujos críticos de los no críticos es la decisión más directa, aunque la más costosa en operación.
La pregunta útil no es "¿tenemos aislamiento?", sino "¿sabemos qué flujos comparten recursos y qué pasa cuando uno se degrada?". Si la respuesta no es explícita, el aislamiento no existe como decisión: existe como accidente.
Dimensionamiento: por qué el promedio engaña
El dimensionamiento de la capa de mediación suele hacerse con datos de operación normal. Ese es el error de base. Los incidentes no ocurren en el promedio; ocurren en los picos, en las degradaciones parciales y en los escenarios donde una dependencia responde más lento de lo habitual.
Tres dimensiones concentran la mayoría de los problemas:
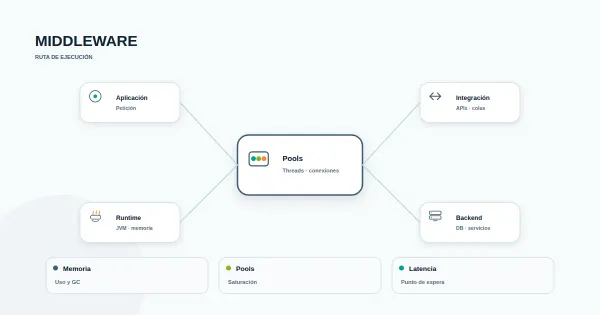
Pool de conexiones a base de datos. El tamaño del pool no se deriva del número de usuarios ni del número de solicitudes por segundo. Se deriva de la concurrencia real que la base de datos puede atender de forma sostenida y del tiempo medio de cada consulta. Un pool sobredimensionado no acelera nada: traslada la presión a la base de datos y produce contención allí. Un pool subdimensionado genera esperas que se manifiestan como latencia en la aplicación, aunque la base de datos esté sana.
Memoria y recolector de basura. Cuando la capa de mediación corre sobre JVM, el dimensionamiento de heap y la elección del recolector condicionan el comportamiento bajo carga. Payloads grandes, sesiones acumuladas, cachés internas y objetos en vuelo presionan la memoria. El síntoma no es un error inmediato, sino pausas crecientes que se traducen en timeouts aguas arriba. Dimensionar para el peor caso razonable, no para el promedio, es lo que evita que un pico se convierta en incidente.
Capacidad de procesamiento. Hilos, CPU y colas internas determinan cuánto trabajo simultáneo tolera la capa. Si el dimensionamiento se hizo para el volumen de hace un año, la degradación ya está en curso aunque todavía no sea visible.
El dimensionamiento correcto no es el más grande ni el más ajustado: es el que corresponde al perfil real de carga y a los tiempos de respuesta de las dependencias aguas abajo.
Alineación de timeouts: la fuente silenciosa de incidentes difíciles
Los timeouts mal alineados entre capas producen una clase particular de incidente: errores que aparecen en un extremo del flujo pero cuya causa está en otro, y que son difíciles de diagnosticar porque el backend nunca ve la solicitud que falló.
El caso típico es una cadena donde el cliente tiene un timeout menor que el de la capa de mediación, y este a su vez menor que el de la base de datos. Cuando la base de datos responde lento, el cliente corta la conexión antes de que el middleware termine de procesar. El middleware sigue trabajando sobre una solicitud que ya nadie espera, consume recursos y eventualmente responde a un socket cerrado. El síntoma visible es un error de integración; la causa real es una decisión de tiempos que nadie revisó en conjunto.
Alinear timeouts no significa igualarlos. Significa que cada capa tenga un margen coherente con la siguiente, de modo que el error se propague de forma controlada y no genere trabajo inútil. Esto se complementa con reintentos acotados y con backoff: reintentos agresivos sobre una dependencia ya degradada amplifican el problema en lugar de resolverlo.
Qué observar para saber si estas decisiones están bien tomadas
Las señales útiles no son las del promedio, sino las que anticipan degradación:
- Latencia descompuesta por tramo. Sin separar el tiempo de entrada, procesamiento en la capa de mediación, llamada al backend y respuesta, no hay forma de ubicar el cuello de botella sin adivinar.
- Uso y espera del pool de conexiones. Conexiones activas, en espera y tiempo medio de espera. Una espera creciente es señal temprana aunque todavía no haya errores visibles.
- Comportamiento del recolector de basura. Frecuencia y duración de pausas, presión de heap, número de hilos activos. Un aumento sostenido de pausas anticipa timeouts.
- Reintentos y aperturas de circuit breaker. Reintentos altos o breakers que se abren con frecuencia indican que algo aguas abajo no responde bien.
- Profundidad de colas y tasa de consumo. Si la cola crece más rápido de lo que se consume, el problema ya está en curso.
- Correlación entre flujos. Cuando varios flujos comparten recursos, la degradación de uno se refleja en los demás. Sin correlación, el origen se atribuye al flujo equivocado.
Estas señales solo son útiles si están asociadas a decisiones concretas: qué flujo comparte qué recurso, qué timeout rige en cada tramo, qué pool atiende qué carga. Un dashboard con métricas aisladas no ayuda a decidir; un mapa del flujo con sus indicadores sí.
Cómo evaluar estas decisiones en tu operación
Evaluar la capa de mediación como decisión arquitectónica implica responder preguntas concretas y verificables:
- ¿Qué flujos comparten pool, hilos o instancia, y qué ocurre cuando uno se degrada?
- ¿El dimensionamiento del pool corresponde a la concurrencia real y al tiempo de respuesta de la base de datos, o al volumen de usuarios?
- ¿Los timeouts están alineados entre capas, o cada una fue configurada de forma independiente?
- ¿Los reintentos están acotados y con backoff, o amplifican la carga sobre dependencias ya degradadas?
- ¿La memoria y el recolector están dimensionados para el peor caso razonable?
- ¿Existe aislamiento entre flujos críticos y no críticos, o la convivencia es accidental?
- ¿La observabilidad cubre el tramo completo o solo los extremos?
Ninguna de estas preguntas se resuelve con una herramienta específica. Se resuelven con decisiones explícitas y con disciplina operativa para revisarlas cuando cambia el perfil de carga. El servicio de Middleware de Mister IT se apoya en este tipo de evaluación cuando la capa intermedia se vuelve un punto de inestabilidad recurrente.
Cierre
La capa de mediación rara vez falla por un defecto aislado. Falla porque un flujo no estaba aislado, porque el dimensionamiento se hizo para el promedio, porque los timeouts no estaban alineados o porque los reintentos amplificaron una degradación parcial. Son decisiones que se toman —o se omiten— mucho antes de que aparezca el incidente.
Revisemos juntos dónde se degrada el flujo entre aplicaciones, APIs y bases de datos en tu operación.