Cinco errores que convierten tu mesa de ayuda en soporte reactivo
¿Tu mesa de ayuda solo reacciona? Detecta los errores operacionales que la mantienen en modo reactivo y corrígelos de forma incremental.
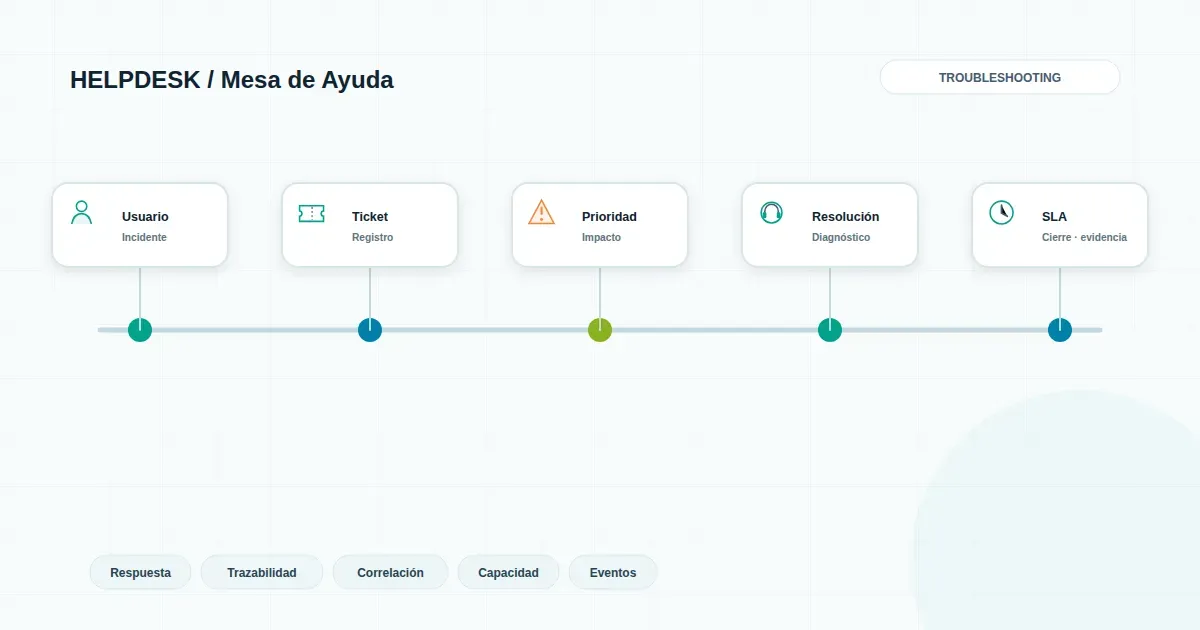
Cuando un usuario reporta un problema y nadie responde en horas, el ticket se pierde o el mismo incidente se reporta tres veces por canales distintos, la mesa de ayuda ya no cumple su función: opera en modo reactivo. Para un gerente TI, detectar estas fallas a tiempo marca la diferencia entre un equipo que controla la operación y uno que apaga incendios.
El problema de fondo: una mesa de ayuda que solo reacciona
Una mesa de ayuda reactiva no es un problema de personas ni de esfuerzo: es un problema de diseño operacional. Cuando no existen criterios claros para priorizar, categorizar o escalar, cada ticket se convierte en un evento aislado que se resuelve según el criterio del técnico de turno. El resultado es predecible: usuarios detenidos sin fecha de resolución, tickets sin trazabilidad y tiempos de atención que varían sin lógica aparente.
El síntoma más evidente es que el equipo siempre está ocupado, pero los incidentes críticos no se resuelven más rápido que los triviales. Si tu mesa de ayuda trabaja "a máxima capacidad" y aun así los usuarios esperan horas por respuestas, el problema no es la carga de trabajo: es la ausencia de un modelo operativo que distinga lo urgente de lo importante.
Errores frecuentes que convierten el soporte en reactivo
Tickets sin priorización efectiva
El error más común es tratar todos los tickets con la misma urgencia. Sin una matriz de priorización basada en impacto y severidad, un usuario que no puede facturar compite en igualdad de condiciones con otro que tiene un problema cosmético en su correo. El equipo resuelve en orden de llegada, no en orden de importancia.
La señal típica: incidentes que afectan a múltiples usuarios o procesos críticos esperan el mismo tiempo que solicitudes menores. Si no puedes responder "¿cuál es el ticket más urgente ahora mismo?" sin revisar la cola completa, no tienes priorización.
Falta de categorización consistente
Cuando los tickets no se clasifican con categorías estandarizadas, es imposible identificar patrones. Un problema recurrente de impresoras en una sucursal específica pasa desapercibido porque cada ticket se registra con una descripción distinta. Sin categorización, no hay visibilidad sobre incidentes repetitivos, equipos con fallas crónicas o aplicaciones que generan tickets desproporcionadamente.
Duplicación de esfuerzos
Un usuario reporta por correo, luego llama y finalmente abre un ticket en el portal. Si la mesa de ayuda no consolida estos canales, el resultado son tres tickets para un mismo problema, tres técnicos trabajando en paralelo y un usuario que recibe tres respuestas inconsistentes. La duplicación no solo desperdicia horas de soporte: destruye la confianza del usuario en el proceso.
Tiempos de atención impredecibles
Sin acuerdos de nivel definidos —aunque sean internos—, cada técnico interpreta "lo antes posible" de manera distinta. Algunos tickets se resuelven en minutos, otros quedan abandonados durante días sin que nadie asuma la responsabilidad. La imprevisibilidad genera que los usuarios escalen por canales informales (WhatsApp, pasillo, jefatura directa), lo que refuerza el comportamiento reactivo.
Nula visibilidad para el usuario
Cuando el usuario no sabe en qué estado está su ticket, llama o escribe nuevamente para preguntar. Cada consulta de estado genera trabajo adicional que no agrega valor: el técnico debe investigar, responder y tranquilizar. La falta de visibilidad convierte a la propia mesa de ayuda en generadora de tickets innecesarios.
Cómo detectar estos errores en tu operación
No necesitas una auditoría formal para identificar si tu mesa de ayuda es reactiva. Con una revisión sistemática de tu cola de tickets puedes encontrar evidencia concreta:
- Revisa la cola actual: ¿Cuántos tickets llevan más de 48 horas sin actualización? ¿Cuántos están asignados pero sin avance real? Una cola con tickets "dormidos" indica que no hay un proceso de seguimiento activo.
- Mide el tiempo de primera respuesta: No el tiempo de resolución, sino el tiempo que transcurre desde que el usuario reporta hasta que alguien le responde. Si supera las dos horas laborales de forma consistente, el problema no es la complejidad de los tickets: es la ausencia de un compromiso de respuesta.
- Identifica tickets reabiertos: Un ticket que se cierra y se reabre es evidencia de que la resolución fue incompleta o que el usuario no quedó satisfecho. Una tasa alta de reapertura indica que el equipo prioriza cerrar tickets sobre resolver problemas.
- Busca duplicados: Revisa si el mismo usuario o el mismo síntoma aparece en múltiples tickets con números distintos. Si encuentras duplicados, tu consolidación de canales no está funcionando.
- Pregunta a tus técnicos: Ellos saben qué tickets son "fantasma" (abiertos pero sin dueño real) y cuáles son "políticos" (escalados por presión, no por criticidad). Su percepción es un dato válido para el diagnóstico.
Corrección incremental sin prometer resultados absolutos
La transformación de una mesa de ayuda reactiva a una proactiva no ocurre de la noche a la mañana, pero sí puedes implementar cambios acotados que generen mejoras visibles en semanas:
- Define categorías básicas: No necesitas una taxonomía compleja. Con cinco o seis categorías (hardware, software, red, acceso, aplicación de negocio, solicitud) puedes empezar a identificar patrones. El objetivo no es la clasificación perfecta, sino poder responder "¿qué tipo de tickets consumen más tiempo?".
- Establece prioridades simples: Una matriz de dos variables —impacto (individual vs. múltiples usuarios) y severidad (bloqueante vs. menor)— es suficiente para empezar. Documenta los criterios por escrito para que todos los técnicos apliquen los mismos estándares.
- Revisa duplicados semanalmente: Dedica 30 minutos a la semana para identificar tickets duplicados y consolidarlos. Esto no solo reduce el trabajo redundante: te muestra qué canales están generando reportes paralelos.
- Implementa un SLA interno de primera respuesta: No necesitas compromisos formales con el negocio. Un acuerdo interno que establezca "todo ticket debe tener una primera respuesta en menos de X horas" crea responsabilidad sin la presión de un contrato.
- Comunica el estado al usuario: Aunque sea un correo automático que confirme la recepción y entregue un número de ticket, la visibilidad básica reduce las consultas de estado y genera confianza en el proceso.
Estas acciones no eliminan todos los problemas de una mesa de ayuda, pero sí rompen el ciclo reactivo al crear estructura mínima donde antes había improvisación. Para una visión más completa sobre cómo estructurar una operación de soporte, puedes revisar nuestra Mesa de ayuda de soporte técnico: guía práctica para empresas que necesitan continuidad y control.
Cuándo considerar apoyo externo
Si después de implementar estas correcciones básicas los tiempos de atención siguen siendo impredecibles, los tickets continúan perdiéndose y el equipo no logra salir del modo reactivo, el problema puede ser estructural: falta de herramientas adecuadas, procesos mal diseñados o un equipo sobredimensionado para la carga real de trabajo.
En ese punto, una evaluación externa puede ayudar a identificar qué está fallando sin el sesgo de quienes operan el día a día. Un proveedor especializado puede aportar metodologías probadas, herramientas de gestión y procesos estandarizados que tu organización no tiene que construir desde cero.
Si estás en esa situación, conversemos sobre cómo evaluar tu Mesa de Ayuda y qué ajustes incrementales podrían sacar a tu operación del modo reactivo. También puede ser útil revisar si tu operación deja el rastro documental necesario: el artículo ¿Tu mesa de ayuda deja rastro? Checklist para auditar su trazabilidad te entrega un punto de partida concreto.
La diferencia entre una mesa de ayuda reactiva y una que controla su operación no está en la cantidad de tickets que resuelve, sino en la capacidad de anticiparse, priorizar y dar visibilidad. Los errores descritos aquí son corregibles; lo importante es diagnosticarlos a tiempo y actuar antes de que el modo reactivo se convierta en la cultura del equipo.
Podemos ayudarte a evaluar tu operación y definir ajustes concretos para salir del modo reactivo.