Monitoreo de redes 24/7: qué observar y cómo evaluarlo
Guía técnica para gerentes TI: qué implica el monitoreo de redes 24/7, qué señales observar y cómo evaluar su adopción en una operación real.
En muchas organizaciones la red funciona como una utilidad: se nota cuando falla, no cuando opera bien. Esa normalidad aparente esconde un problema de gestión. Si nadie observa la red de forma continua, la primera señal de un incidente suele ser el reclamo de un usuario, una transacción rechazada o un servicio que dejó de responder. Para un gerente TI, la pregunta relevante no es si conviene monitorear la red, sino qué implica hacerlo 24/7, qué señales observar y cómo evaluar si la operación actual está a la altura.
Qué implica monitoreo de redes 24/7 en una operación empresarial
Monitoreo de redes 24/7 no significa tener una pantalla encendida todo el día. Significa que existe una capacidad operativa sostenida para recolectar métricas y eventos de la infraestructura de red, correlacionarlos, detectar desviaciones y activar una respuesta, sin depender de que alguien esté mirando en el momento exacto en que ocurre el problema.
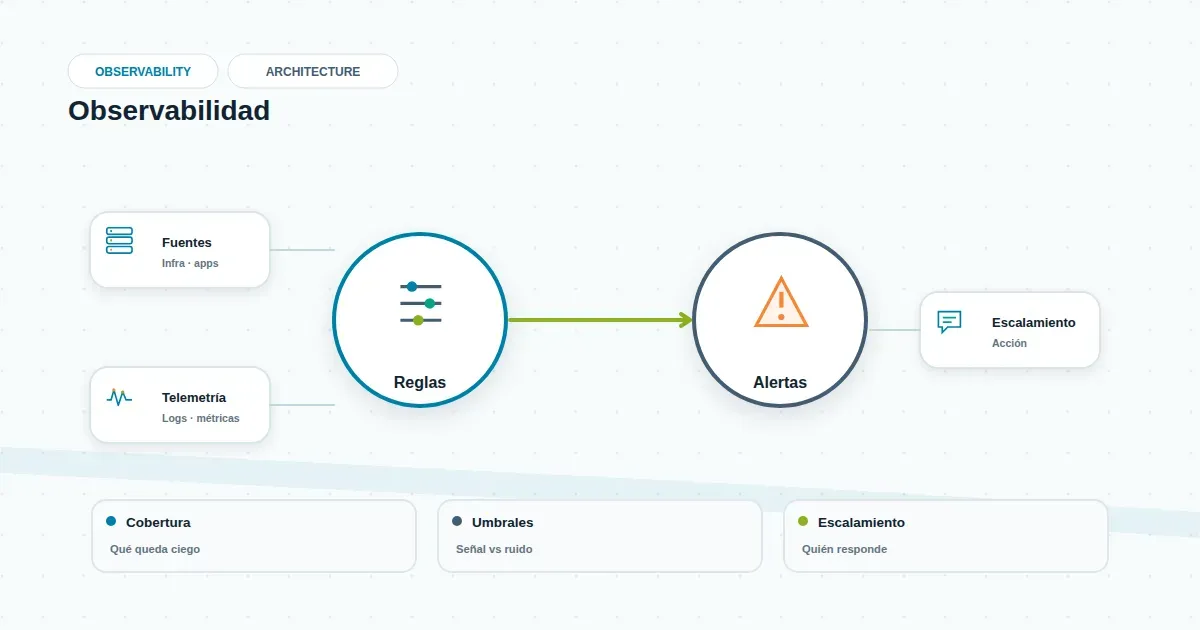
Esa capacidad tiene cuatro componentes que conviene distinguir:
- Cobertura: qué dispositivos, enlaces, segmentos y servicios de red están bajo observación. Una red parcialmente monitoreada produce una falsa sensación de control.
- Recolección: cómo se obtienen los datos (SNMP, syslog, sondas, flujos, agentes) y con qué frecuencia. La frecuencia define la granularidad con que se puede reconstruir un incidente.
- Procesamiento y alertamiento: reglas, umbrales y correlación que convierten datos crudos en señales accionables.
- Respuesta: quién recibe la alerta, con qué procedimiento y en qué horario. Sin este componente, el monitoreo es observación pasiva.
El dolor operacional que resuelve es concreto: caídas no detectadas a tiempo, alertas que llegan cuando el impacto ya ocurrió, baja visibilidad sobre la causa raíz y pérdida de continuidad. Cuando la red se monitorea de forma continua, esos eventos dejan de descubrirse por accidente.
Señales técnicas de red que conviene observar de forma continua
No todas las métricas tienen el mismo valor. Estas son las que suelen sostener una operación de red bajo observación continua:
Disponibilidad y alcanzabilidad. Estado de interfaces, túneles, enlaces WAN y equipos críticos. Es la señal más básica, pero también la que más rápido envejece si no se complementa con las siguientes.
Latencia y variación (jitter). El promedio oculta la experiencia real. Conviene observar percentiles (P95, P99) y no solo medias, porque los usuarios perciben los peores casos, no el promedio del día.
Pérdida de paquetes. Incluso tasas bajas sostenidas degradan aplicaciones sensibles sin provocar una caída visible. Es una señal que rara vez aparece en un reporte ejecutivo y que explica buena parte de los reclamos difusos de "la red está lenta".
Uso de ancho de banda por enlace y por segmento. Permite anticipar saturación y distinguir entre un problema de capacidad y uno de configuración.
Errores y descartes en interfaces. Colisiones, CRC, drops y errores de alineación suelen anticipar fallas de hardware o de cableado antes de que el enlace caiga.
Estado de protocolos de enrutamiento y redundancia. Cambios de vecindad, convergencias y flaps indican inestabilidad que puede no traducirse aún en indisponibilidad.
Disponibilidad de servicios dependientes de red. DNS, DHCP, autenticación, VPN y balanceadores. Una red "arriba" con DNS degradado es, para el negocio, una red caída.
Eventos de configuración y cambios. Saber qué cambió y cuándo es tan importante como saber qué falló. Sin trazabilidad de cambios, el diagnóstico se vuelve especulación.
La combinación de estas señales permite pasar de "la red falló" a "la red falló por esta causa, en este punto, a esta hora".
Cómo funciona una operación de monitoreo continuo y dónde suele fallar
Una operación de monitoreo continuo se organiza en capas: recolección distribuida mediante sondas o agentes cerca de la fuente; normalización y almacenamiento para consultar histórico y no solo el estado actual; correlación y alertamiento, donde se define qué constituye una anomalía y con qué severidad; y gestión de incidentes con escalamiento, registro y cierre.
Los puntos de falla más frecuentes no están en la herramienta, sino en el diseño de la operación:
- Umbrales mal calibrados. Demasiado sensibles generan fatiga de alertas; demasiado laxos dejan pasar degradaciones. Ambos extremos terminan en lo mismo: nadie confía en las alertas.
- Monitoreo sin línea base. Sin conocer el comportamiento normal de la red, es imposible definir qué es anómalo. La línea base se construye observando, no adivinando.
- Cobertura con puntos ciegos. Segmentos de usuarios, enlaces de proveedores o equipos de borde que quedan fuera del alcance. Los incidentes suelen originarse justamente ahí.
- Alertas sin procedimiento. Una alerta que no tiene destinatario claro ni acción definida es ruido, no monitoreo.
- Ausencia de revisión periódica. La red cambia: nuevos servicios, enlaces y consumos. Un monitoreo que no se revisa se desactualiza en meses.
Cuando estos puntos fallan, la organización cree tener monitoreo 24/7 porque hay una herramienta instalada, pero en la práctica sigue enterándose de los problemas por los usuarios.
Errores frecuentes y límites al monitorear redes 24/7
Más allá de los puntos de falla operativos, hay errores de enfoque que conviene reconocer:
Confundir monitoreo con observabilidad completa. El monitoreo de red responde "¿está funcionando y cómo?". La observabilidad profunda de aplicaciones es otra disciplina. Ambas se complementan, pero no se sustituyen.
Asumir que más métricas es mejor. Recolectar todo sin criterio produce costo de almacenamiento, ruido y dificultad para encontrar lo relevante. La selección de señales es una decisión de gestión, no solo técnica.
Ignorar el costo de la operación continua. Monitorear 24/7 implica turnos, guardias, procedimientos y personas capacitadas. Es una capacidad operativa, no solo una licencia de software.
Esperar detección perfecta. Ningún esquema de monitoreo detecta el 100% de los incidentes. El objetivo realista es reducir el tiempo entre la ocurrencia y la detección, y tener información suficiente para diagnosticar rápido.
Descuidar la trazabilidad. En contextos donde se requiere preparación para normativas como la Ley 21.719, la capacidad de demostrar qué pasó, cuándo y con qué controles es parte del valor del monitoreo. No se trata de garantizar cumplimiento, sino de contar con registros y controles que faciliten la preparación y la respuesta ante incidentes.
Reconocer estos límites evita expectativas mal puestas y permite diseñar una operación proporcionada al riesgo real de cada organización.
Criterios prácticos para evaluar monitoreo de redes 24/7 en tu operación
Para decidir si la operación actual es suficiente o si requiere cambios, conviene responder preguntas concretas:
- ¿Cuánto tarda la organización en enterarse de una caída de red? Si la respuesta es "cuando alguien reclama", hay una brecha de detección.
- ¿Qué porcentaje de la red está efectivamente bajo observación? Identificar puntos ciegos es el primer paso para cerrarlos.
- ¿Las alertas actuales son accionables? Si la mayoría se ignora o se pospone, el problema es de diseño, no de volumen.
- ¿Existe histórico consultable? Sin datos históricos no hay análisis de causa raíz ni mejora continua.
- ¿Quién responde fuera de horario? El "24/7" se prueba en la madrugada y los fines de semana, no en horario hábil.
- ¿La operación se revisa periódicamente? Cobertura, umbrales y procedimientos deben actualizarse con la red.
Si varias de estas respuestas son insatisfactorias, el problema no es necesariamente la herramienta: suele ser el diseño de la operación. Un servicio de Monitoreo TI 24x7 bien estructurado aborda precisamente esos puntos: cobertura definida, señales seleccionadas, alertamiento con procedimiento y respuesta sostenida en el tiempo.
La decisión de fondo es de gestión: qué nivel de visibilidad necesita la operación para sostener la continuidad, y qué capacidad está dispuesta a mantener la organización para lograrlo.
Conversemos sobre cómo evaluar Monitoreo TI 24x7 en tu operación.