El papel del middleware en el flujo entre aplicaciones, APIs y bases de datos
El middleware orquesta el flujo entre aplicaciones, APIs y bases de datos. Conoce su rol, puntos de fallo y criterios para evaluarlo.
Cuando una aplicación transaccional empieza a responder lento, el equipo de operaciones suele mirar primero la base de datos. Luego revisa la red. Después quizás el almacenamiento. Pero en muchas arquitecturas actuales, el cuello de botella no está en ninguno de esos puntos: está en la capa que conecta todo, esa que rara vez se monitorea con la misma atención que los extremos del camino.
Esa capa es el middleware, y entenderla como un orquestador —no como un simple conector— cambia la forma en que se diagnostican latencias, errores de integración y aplicaciones inestables.
El middleware como capa de orquestación entre aplicaciones, APIs y bases de datos
El middleware dejó de ser hace tiempo ese "pegamento" entre sistemas legacy y bases de datos. En una arquitectura moderna, es el punto donde se decide cómo, cuándo y hacia dónde viaja cada mensaje entre una aplicación, una API y un repositorio de datos.
Su rol no es solo traducir protocolos o transformar formatos. Es un orquestador que gestiona:
- Enrutamiento inteligente: decide qué instancia de servicio recibe cada solicitud según disponibilidad, carga o afinidad de datos.
- Transacciones distribuidas: coordina operaciones que tocan múltiples bases de datos o servicios, asegurando que todas se confirmen o ninguna lo haga.
- Colas y mensajería asíncrona: desacopla productores de consumidores para que una caída puntual no bloquee todo el proceso.
- Caché distribuida: evita que cada petición termine golpeando la base de datos cuando el dato no ha cambiado.
- Seguridad perimetral: valida credenciales, tokens y políticas de acceso antes de que la solicitud llegue al recurso final.
Cuando el middleware funciona bien, nadie nota su existencia. Cuando falla, el síntoma se atribuye casi siempre a la aplicación o a la base de datos, porque es ahí donde se manifiesta el dolor. Esa es exactamente la dificultad de diagnosticar problemas en esta capa: el middleware es invisible hasta que deja de serlo.
El recorrido de una petición: dónde interviene el middleware y dónde puede fallar
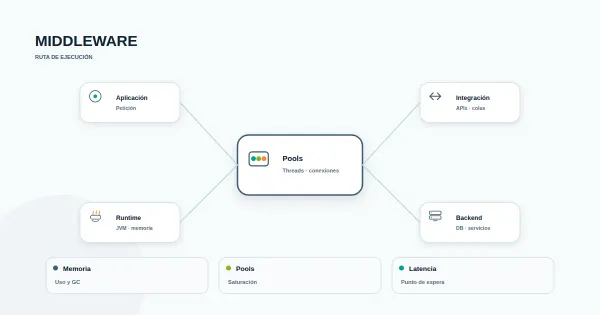
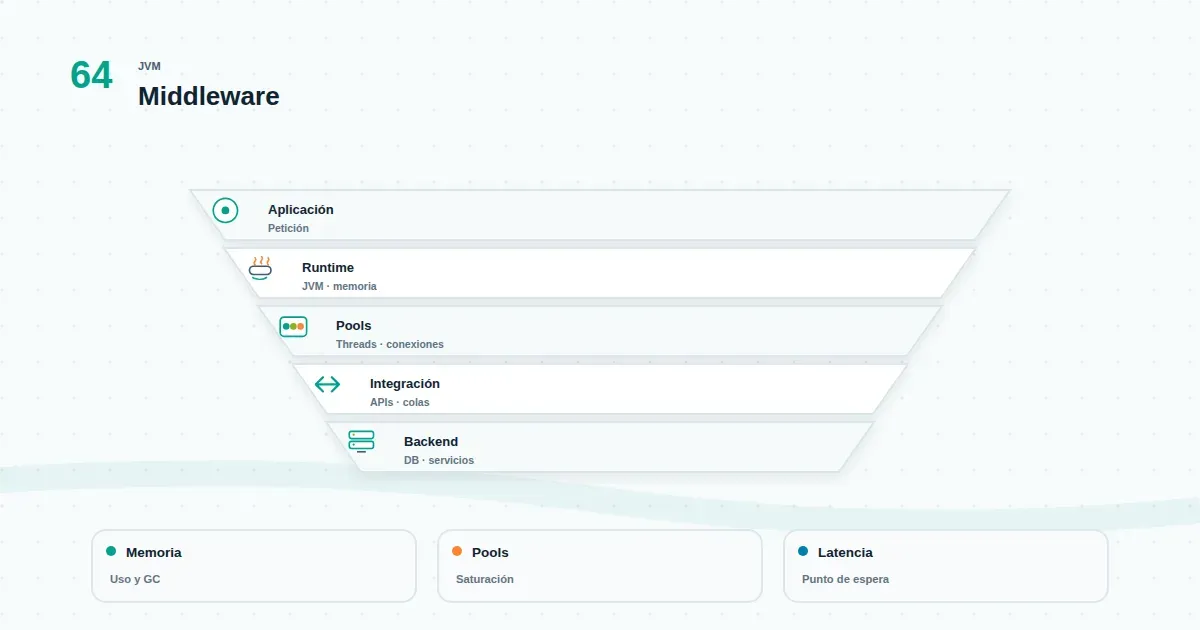
Para entender dónde puede fallar el flujo, conviene seguir el camino completo de una petición típica en una arquitectura con middleware.
Paso 1: La aplicación genera la solicitud. Un usuario ejecuta una acción en el frontend. La aplicación backend construye una llamada, generalmente HTTP/REST o gRPC, y la envía al endpoint correspondiente.
Paso 2: El middleware intercepta la llamada. Aquí ocurren varias cosas en milisegundos:
- El API Gateway (si existe) valida la autenticación, aplica rate limiting y verifica que el cliente tenga permisos.
- El message broker (si la comunicación es asíncrona) publica el mensaje en una cola o tópico.
- El orquestador de servicios determina qué instancia del microservicio destino debe recibir la solicitud.
Paso 3: El servicio procesa y consulta datos. El microservicio destino recibe la solicitud, ejecuta su lógica de negocio y necesita leer o escribir datos. Ahí aparece el segundo rol del middleware: la gestión del acceso a la base de datos mediante connection pools.
Paso 4: La respuesta regresa por el mismo camino. El resultado viaja de vuelta al middleware, que puede aplicar transformaciones, caching o logging antes de devolver la respuesta al cliente.
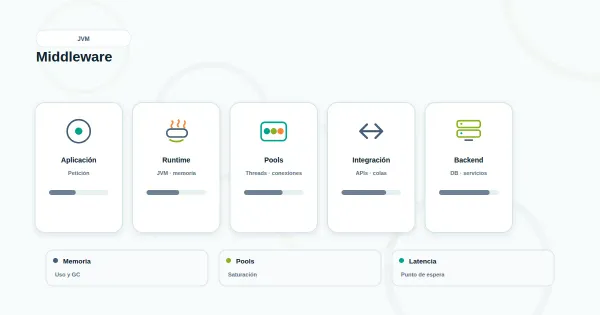
En cada uno de estos pasos hay recursos finitos: hilos de ejecución, conexiones a base de datos, memoria en la JVM, espacio en colas. El middleware administra esos recursos compartidos, y cuando alguno se agota, el efecto dominó se siente en toda la cadena.
Señales de que el middleware está fallando: latencia, JVM y pools agotados
Cuando el middleware deja de cumplir su rol, los síntomas aparecen en distintos niveles. Estos son los más comunes y lo que realmente indican:
Latencia creciente sin causa aparente en la base de datos
Si las consultas a la base de datos responden en tiempos normales pero la aplicación percibe lentitud, el problema puede estar en el tiempo de espera dentro del middleware. Colas acumuladas, hilos bloqueados esperando recursos o serialización de mensajes pueden agregar cientos de milisegundos sin que ningún componente individual muestre un problema evidente.
Saturación de la JVM
Las plataformas de middleware basadas en Java (muy comunes en integración empresarial) dependen de la JVM para gestionar memoria y ejecución. Cuando el heap se llena, el Garbage Collector entra en ciclos cada vez más frecuentes y prolongados, deteniendo la aplicación (stop-the-world) para liberar espacio. El resultado: picos de latencia que no se correlacionan con el volumen de peticiones.
Pools de conexiones agotados
Cada solicitud que necesita acceder a la base de datos toma una conexión del pool. Si el pool está configurado con 50 conexiones y llegan 80 peticiones simultáneas que requieren base de datos, 30 quedan esperando. Si el tiempo de espera excede el timeout configurado, se generan errores de tipo "Connection is not available" o "Connection pool exhausted".
Lo crítico: el pool agotado casi nunca es la causa raíz. Es el síntoma de que las peticiones están tardando más de lo esperado en liberar las conexiones, ya sea por consultas lentas, por lógica de negocio ineficiente o por un middleware que no está liberando recursos correctamente.
Errores de integración intermitentes
Cuando los servicios se comunican a través del middleware, los fallos de serialización, los timeouts mal configurados o las políticas de reintento agresivas pueden generar errores que aparecen y desaparecen. Estos son los más difíciles de diagnosticar porque no dejan un rastro consistente.
Criterios para evaluar si tu capa de middleware cumple su rol
No se trata de esperar a que algo falle para revisar el middleware. Estos son los puntos que un equipo de operaciones debería verificar de forma proactiva:
1. ¿Tienes visibilidad del flujo completo? No basta con monitorear la aplicación y la base de datos por separado. Necesitas trazabilidad distribuida que te muestre cuánto tiempo pasa cada petición en cada salto, incluyendo el tiempo dentro del middleware.
2. ¿Las colas tienen profundidad saludable? Una cola que crece constantemente indica que los consumidores no dan abasto. Una cola vacía puede ser normal, pero si se llena en horas pico y tarda en drenarse, hay un desbalance entre producción y consumo.
3. ¿Los pools están dimensionados correctamente? El tamaño del pool de conexiones no debería ser un número fijo que se toca solo cuando hay errores. Debería calcularse según el tiempo de respuesta de las consultas, el throughput esperado y el número de instancias del servicio.
4. ¿Los timeouts están definidos en cada salto? Un timeout demasiado largo enmascara problemas; uno demasiado corto genera errores falsos. Cada comunicación entre componentes debería tener un timeout explícito y un mecanismo de reintento con backoff.
5. ¿El middleware escala horizontalmente? Si tu middleware es un punto único de fallo o no puede agregar instancias bajo demanda, cualquier crecimiento en el tráfico lo convertirá en el cuello de botella de toda la arquitectura.
6. ¿Tienes un plan para cuando falle? El middleware concentra comunicaciones críticas. Si cae, ¿qué pasa con las peticiones en tránsito? ¿Las colas persisten los mensajes? ¿Hay un mecanismo de failover que no requiera intervención manual?
Evaluar estos puntos no es un ejercicio teórico. Es la diferencia entre detectar un problema de integración cuando aparece o descubrirlo cuando los usuarios reportan que "el sistema está lento" y el equipo pierde horas revisando bases de datos que responden perfectamente. Si tu equipo necesita apoyo para revisar la capa de Middleware con criterios técnicos y sin sesgos de proveedor, una evaluación externa puede ayudar a identificar lo que la operación diaria tiende a normalizar.
Conclusión: el middleware como punto ciego de la arquitectura
El middleware cumple un papel estructural: sin él, las aplicaciones no podrían comunicarse con las APIs ni acceder a los datos de forma coordinada. Pero su misma naturaleza —ser una capa intermedia— lo convierte en el componente más difícil de diagnosticar cuando algo falla.
Si has enfrentado latencias inexplicables, pools agotados o errores de integración intermitentes, vale la pena revisar la capa que conecta todo. Muchas veces, el problema no está en los extremos del camino, sino en el orquestador que los une.
En Mister IT trabajamos precisamente en esa capa: ayudar a equipos de operaciones a evaluar si su Middleware está cumpliendo su rol o si se ha convertido en un punto ciego de la arquitectura. No se trata de vender una solución genérica, sino de diagnosticar cómo fluye —o deja de fluir— la información entre tus aplicaciones, APIs y datos.
Conversemos sobre cómo evaluar Middleware en tu operación.