Wazuh para detección de vulnerabilidades en endpoints: qué evaluar
Evaluar la detección de vulnerabilidades en endpoints con Wazuh exige medir cobertura, frescura y correlación antes de asumir que la capacidad está lista.
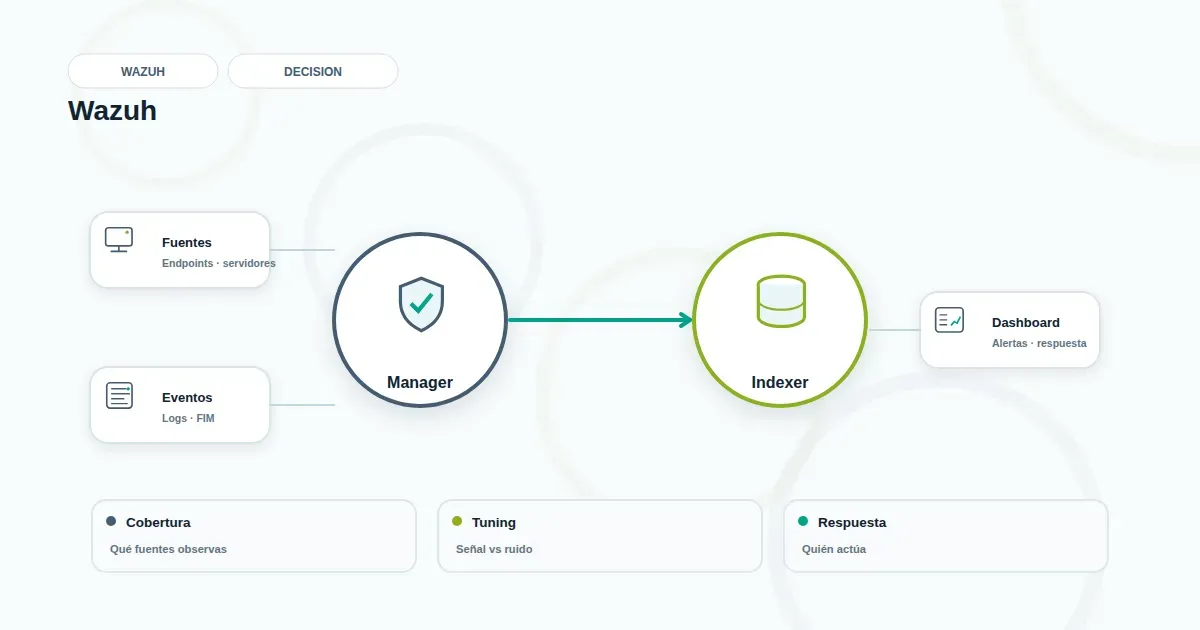
La detección de vulnerabilidades en endpoints suele tratarse como una casilla más del stack de seguridad. En la práctica, condiciona la visibilidad real del parque de equipos y la calidad de las decisiones de priorización. Wazuh ofrece un módulo de detección de vulnerabilidades basado en agente, pero evaluarlo exige separar lo que la herramienta reporta de lo que la operación puede sostener.
Este artículo no explica cómo instalar ni configurar el módulo. Propone criterios para decidir si esta capacidad encaja en tu entorno, qué señales técnicas observar y qué límites conviene asumir antes de comprometer recursos.
Qué implica la detección de vulnerabilidades en endpoints con Wazuh en un entorno empresarial
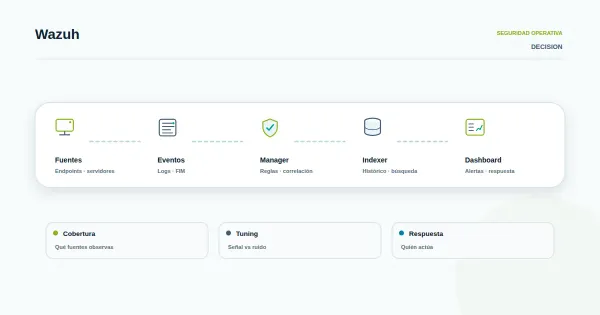
El módulo se apoya en el agente desplegado en cada endpoint. El agente recopila el inventario de software instalado y lo contrasta con fuentes de vulnerabilidades conocidas para identificar paquetes o versiones afectadas. El resultado se presenta como hallazgos asociados a un activo concreto, con su severidad y referencias.
La calidad de la detección depende de la calidad del inventario. Si el agente no está en un equipo, ese equipo no existe para el módulo. Si el inventario está incompleto o desactualizado, los hallazgos también lo estarán. No es un escaneo de red que descubre activos: observa lo que el agente ya conoce.
Conviene distinguir tres planos:
- Cobertura: qué proporción del parque tiene agente activo y reportando.
- Frescura: con qué frecuencia se actualiza el inventario y las fuentes de vulnerabilidades.
- Contexto: si el hallazgo se puede cruzar con criticidad del activo, exposición, cambios recientes y eventos de seguridad.
El dolor operacional que atiende es concreto: eventos dispersos, baja correlación entre señales y falta de visibilidad sobre qué equipos están expuestos. Pero la detección de vulnerabilidades, por sí sola, no resuelve ese dolor. Lo hace cuando se integra con inventario confiable, correlación con cambios no autorizados y una ruta clara de priorización.
Señales técnicas que conviene observar al evaluar esta capacidad
Antes de decidir, conviene medir. Estas señales indican si la detección funciona como capacidad operativa y no solo como módulo activo.
Cobertura efectiva del parque. No basta con contar agentes instalados. Hay que verificar cuántos reportan de forma sostenida, cuántos están desconectados y cuántos equipos del inventario corporativo no tienen agente. Un porcentaje alto de agentes instalados con un porcentaje bajo de agentes activos indica un problema de operación, no de herramienta.
Calidad y actualización del inventario. El módulo depende de que el inventario refleje la realidad del endpoint. Software instalado fuera de los canales habituales, versiones portables o cambios frecuentes pueden desfasarlo. Observa con qué frecuencia se refresca y si los cambios de software se reflejan en un plazo razonable.
Frescura de las fuentes de vulnerabilidades. La detección pierde valor si las fuentes que alimentan el contraste no se actualizan con regularidad. Un hallazgo que no aparece porque la fuente está atrasada genera una falsa sensación de cobertura.
Correlación con eventos de seguridad. Un hallazgo aislado es un dato. Un hallazgo que se cruza con un cambio no autorizado, con un evento de autenticación anómalo o con un proceso sospechoso es una señal accionable. Evalúa si la operación puede correlacionar estos planos o si cada uno vive en su propio dashboard.
Trazabilidad del hallazgo. Para priorizar y rendir cuentas, conviene poder responder: cuándo se detectó, en qué activo, con qué versión, qué severidad tenía y qué se hizo al respecto. Si el flujo se pierde entre detección y remediación, la capacidad no está cerrada.
Comportamiento ante cambios no autorizados. La detección de vulnerabilidades y la monitorización de integridad de ficheros (FIM) son capacidades distintas que se complementan. Un cambio no autorizado que introduce software vulnerable es un escenario donde ambas señales deberían converger. Observa si la operación las trata por separado o las integra.
Volumen y ruido. Un parque grande genera muchos hallazgos. Si el volumen supera la capacidad de triage, el equipo deja de mirar. La señal relevante no es cuántos hallazgos hay, sino cuántos se revisan y cuántos se cierran con una acción verificable.
Límites, errores frecuentes y buenas prácticas
La detección basada en agente tiene límites que conviene asumir antes de comprometer expectativas.
Dependencia del agente. Los equipos sin agente quedan fuera: dispositivos de red, appliances, equipos personales no gestionados y sistemas donde el agente no es viable. La cobertura nunca es total, y la operación debe saber qué queda fuera y por qué.
Datos desactualizados. Un inventario que no se refresca o una fuente atrasada producen una imagen falsa del riesgo. La frescura no es un detalle de configuración: es una condición de validez del resultado.
Ruido y falsos positivos. No todo hallazgo es explotable en tu contexto. Una vulnerabilidad de severidad alta en un activo aislado y sin exposición puede ser menos urgente que una de severidad media en un servidor expuesto. Sin contexto de criticidad, el equipo prioriza por severidad bruta, que no siempre coincide con el riesgo real.
Falta de correlación. Si los hallazgos viven en un dashboard separado de los eventos de seguridad y de los cambios, la operación pierde la capacidad de detectar patrones. La correlación convierte hallazgos dispersos en visibilidad.
Ausencia de tuning. Un módulo sin ajuste genera volumen que el equipo no puede absorber. El tuning no es solo reducir alertas: es asegurar que lo que llega al analista sea accionable. Sin capacidad de triage, el módulo se convierte en deuda operativa.
Buenas prácticas que marcan diferencia:
- Definir qué activos son críticos y asegurar su cobertura antes de ampliar el parque.
- Establecer una cadencia de refresco de inventario y fuentes, y verificarla.
- Integrar los hallazgos con el flujo de cambios y con los eventos de seguridad.
- Documentar el ciclo de vida del hallazgo: detección, triage, remediación, verificación.
- Revisar cobertura y frescura como indicadores operativos, no como métricas de vanidad.
Criterios prácticos para decidir si encaja en tu operación
La decisión no es si Wazuh puede detectar vulnerabilidades en endpoints, sino si tu operación puede sostener esa capacidad con la calidad necesaria. El foco aquí no es evaluar el SIEM en general, sino esta capacidad específica: cobertura, frescura y correlación de hallazgos de vulnerabilidades en endpoints. Estas preguntas ayudan a orientarla:
- ¿Qué proporción del parque crítico tiene agente activo y reportando de forma sostenida? Si la cobertura del parque crítico es baja, la capacidad no está lista para producción, independientemente de la herramienta.
- ¿Con qué frecuencia se refresca el inventario y las fuentes de vulnerabilidades? Si no puedes verificar la frescura, no puedes confiar en los hallazgos.
- ¿Existe un flujo definido entre detección, triage y remediación? Sin flujo, los hallazgos se acumulan sin acción.
- ¿La operación puede correlacionar hallazgos con cambios y eventos de seguridad? Si cada plano vive aislado, la visibilidad sigue fragmentada.
- ¿Hay capacidad de triage para el volumen esperado? Si el volumen supera la capacidad, el módulo genera ruido en lugar de señal.
- ¿Qué queda fuera de la cobertura y cómo se gestiona? Los equipos sin agente requieren una estrategia alternativa o una aceptación explícita del riesgo.
Si las respuestas muestran cobertura parcial, frescura no verificada o ausencia de flujo de remediación, la capacidad no está madura para producción. Eso no invalida la herramienta: indica que la operación necesita construir las condiciones antes de ampliar el alcance.
En entornos donde el equipo interno no puede sostener cobertura, frescura y triage de forma continua, conviene evaluar un modelo operado. Wazuh como Servicio permite mantener la capacidad con condiciones de operación definidas, sin que la detección de vulnerabilidades dependa de la disponibilidad del equipo interno. La decisión, en cualquier caso, debe basarse en las señales anteriores, no en la promesa de la herramienta.
La detección de vulnerabilidades en endpoints es útil cuando se integra con inventario confiable, correlación y un flujo de remediación verificable. Evaluarla con criterios operativos, y no solo técnicos, permite decidir si encaja en tu entorno o si antes hay que cerrar brechas de cobertura y visibilidad.
Conversemos sobre cómo evaluar Wazuh como Servicio en tu operación.